在 FlyEnv 中使用 llama.cpp
llama.cpp 使用 C 和 C++ 运行大语言模型推理。FlyEnv 插件将运行时安装、GGUF 模型下载和本地推理服务整合到同一模块,并提供 CPU 与 GPU 设置。
从 设置 → 插件市场 安装 llama.cpp。侧边栏中的模块包含 服务、版本管理、模型、设置 和 日志 标签页。
视频演示
观看如何在 FlyEnv 中安装插件、管理运行时与 GGUF 模型、调整模型设置并启动本地推理服务。
运行时版本与后端
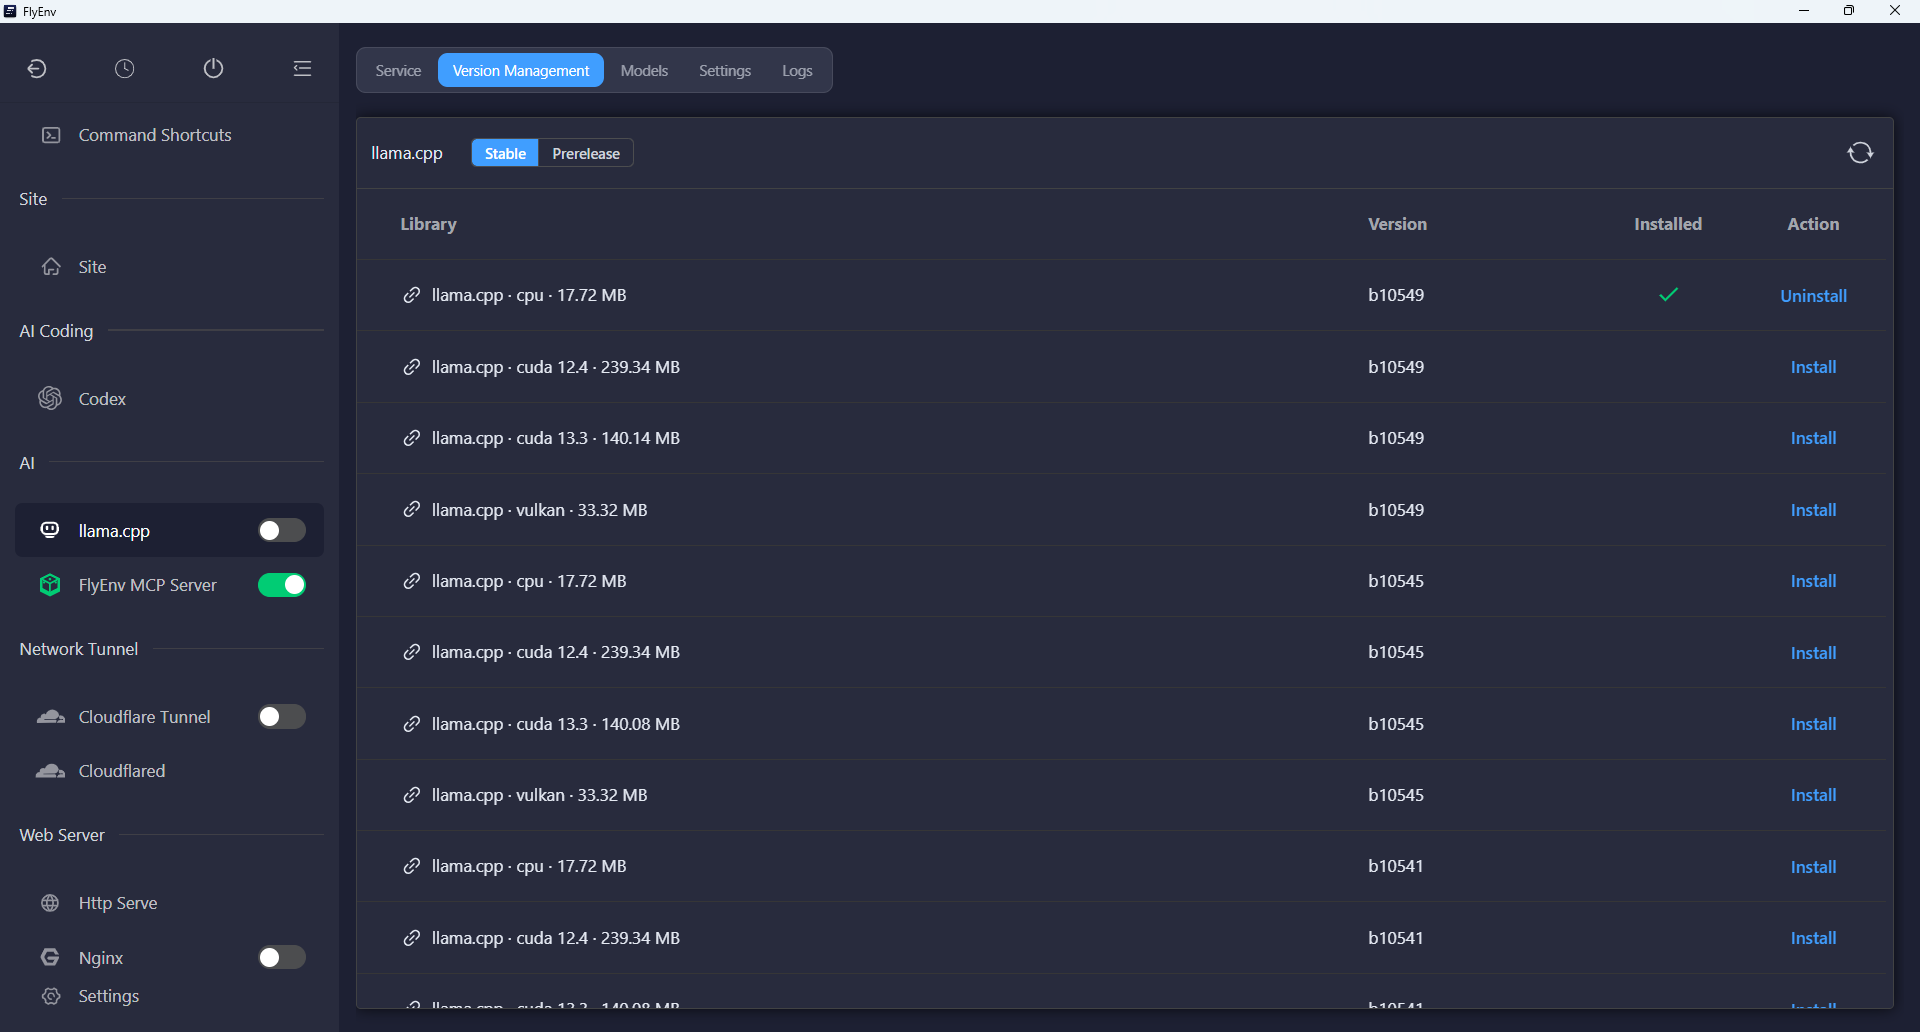
版本管理 列出与当前操作系统及架构兼容的上游发行构建。刷新列表后,选择版本和后端,安装所需运行时。列表会区分稳定版与预发布版。
不同运行时版本可以同时下载并分别保留。在 服务 页选择要启动的已安装版本;额外安装一个版本,并不会自动启动另一个服务。
在上游提供对应发行文件的前提下,插件支持以下组合:
- Apple Silicon macOS: Metal 构建。
- Windows x64: CPU、CUDA 和 Vulkan 构建。
- Linux x64: CPU、CUDA 和 Vulkan 构建。
- Linux ARM64: CPU 和 Vulkan 构建。
CUDA 版本还会安装与其匹配的依赖归档。FlyEnv 会检查安装后的服务端可执行文件,再将其认定为可用运行时;GPU 驱动和系统库仍需满足对应构建的要求。
GGUF 模型库
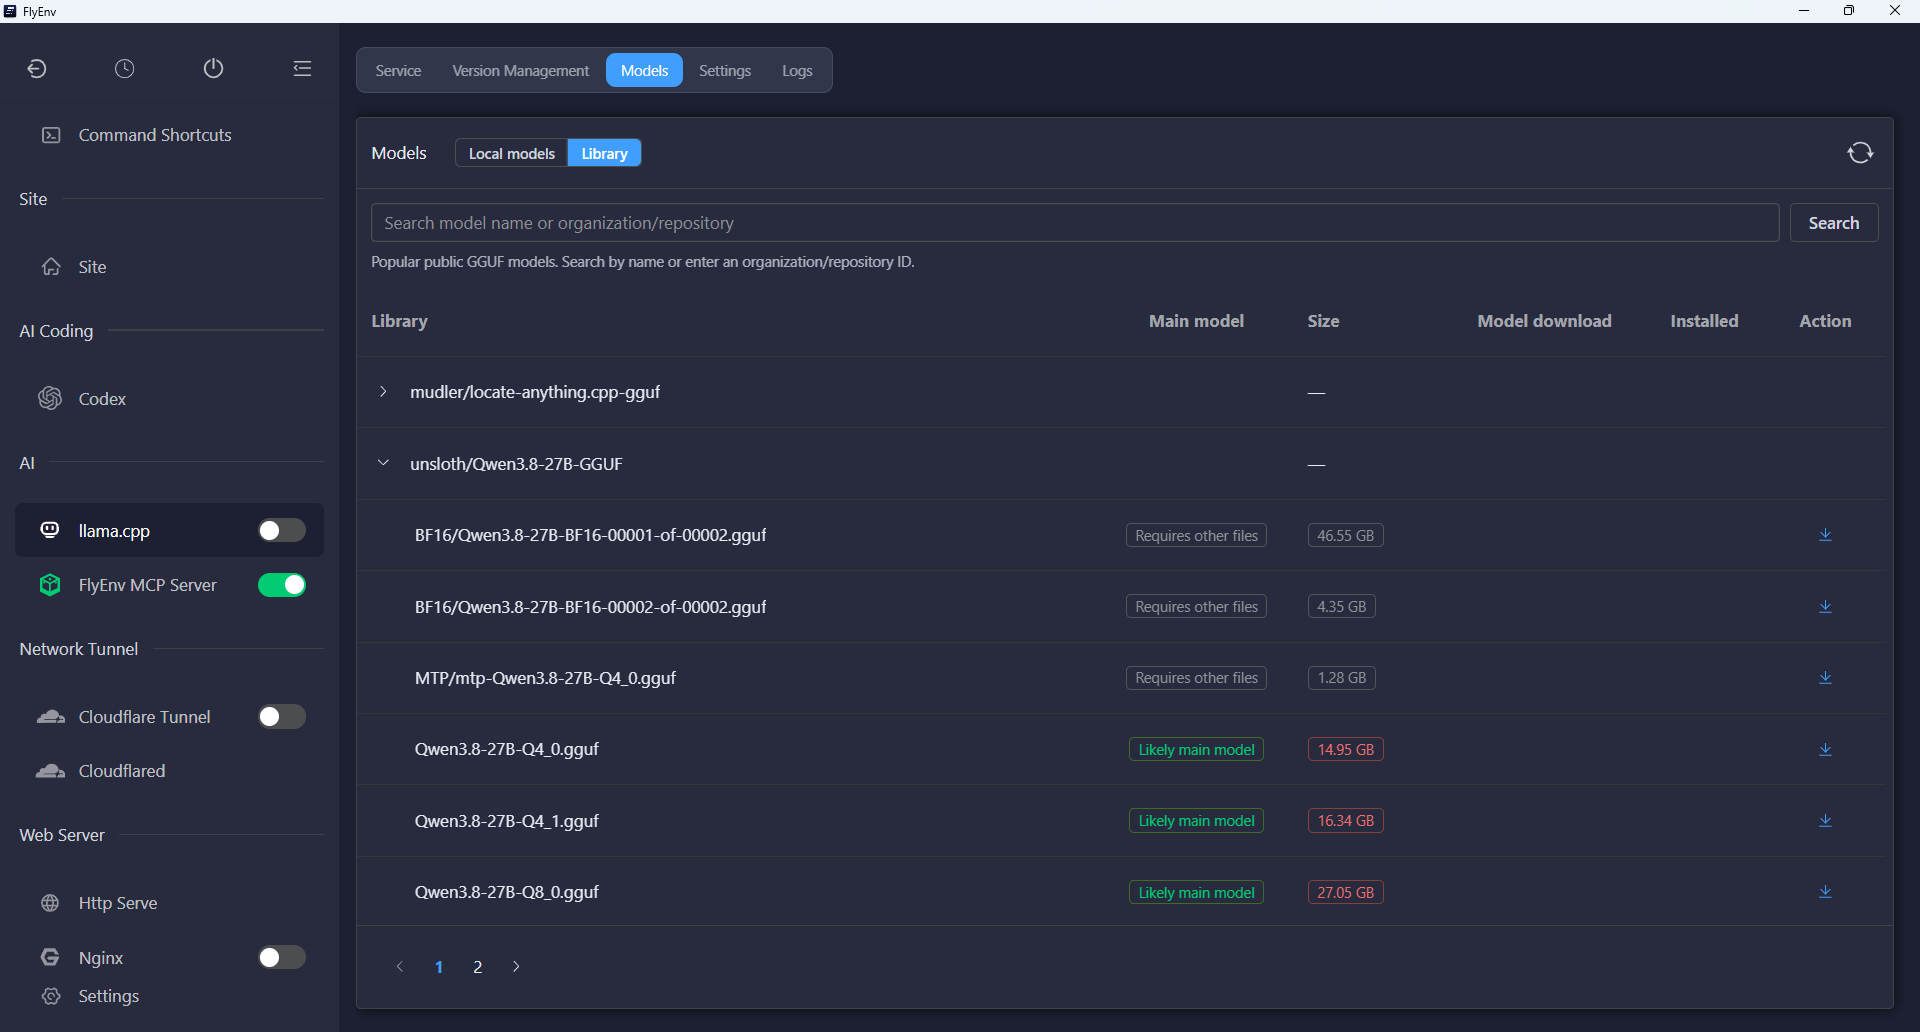
打开 模型 → 模型库,即可浏览 Hugging Face 上的公开 GGUF 仓库。可以搜索模型名称或输入“组织/仓库”ID,展开文件列表,并在下载前比较大小。界面还会显示仓库信息、已提供的模型许可证,以及本机 RAM/VRAM 概况。
下载过程中会显示进度,也可取消。本地模型 列出已下载文件,并提供选择和删除操作。模型库会区分可能的主模型与辅助文件;服务选择器只接受可独立使用的 GGUF 模型。分片文件及依赖其他资源的文件,不能作为独立模型直接启动。
请选择适合可用内存的模型。模型大小、上下文长度和 GPU 卸载设置都会影响运行时的资源需求。
启动所选模型的服务
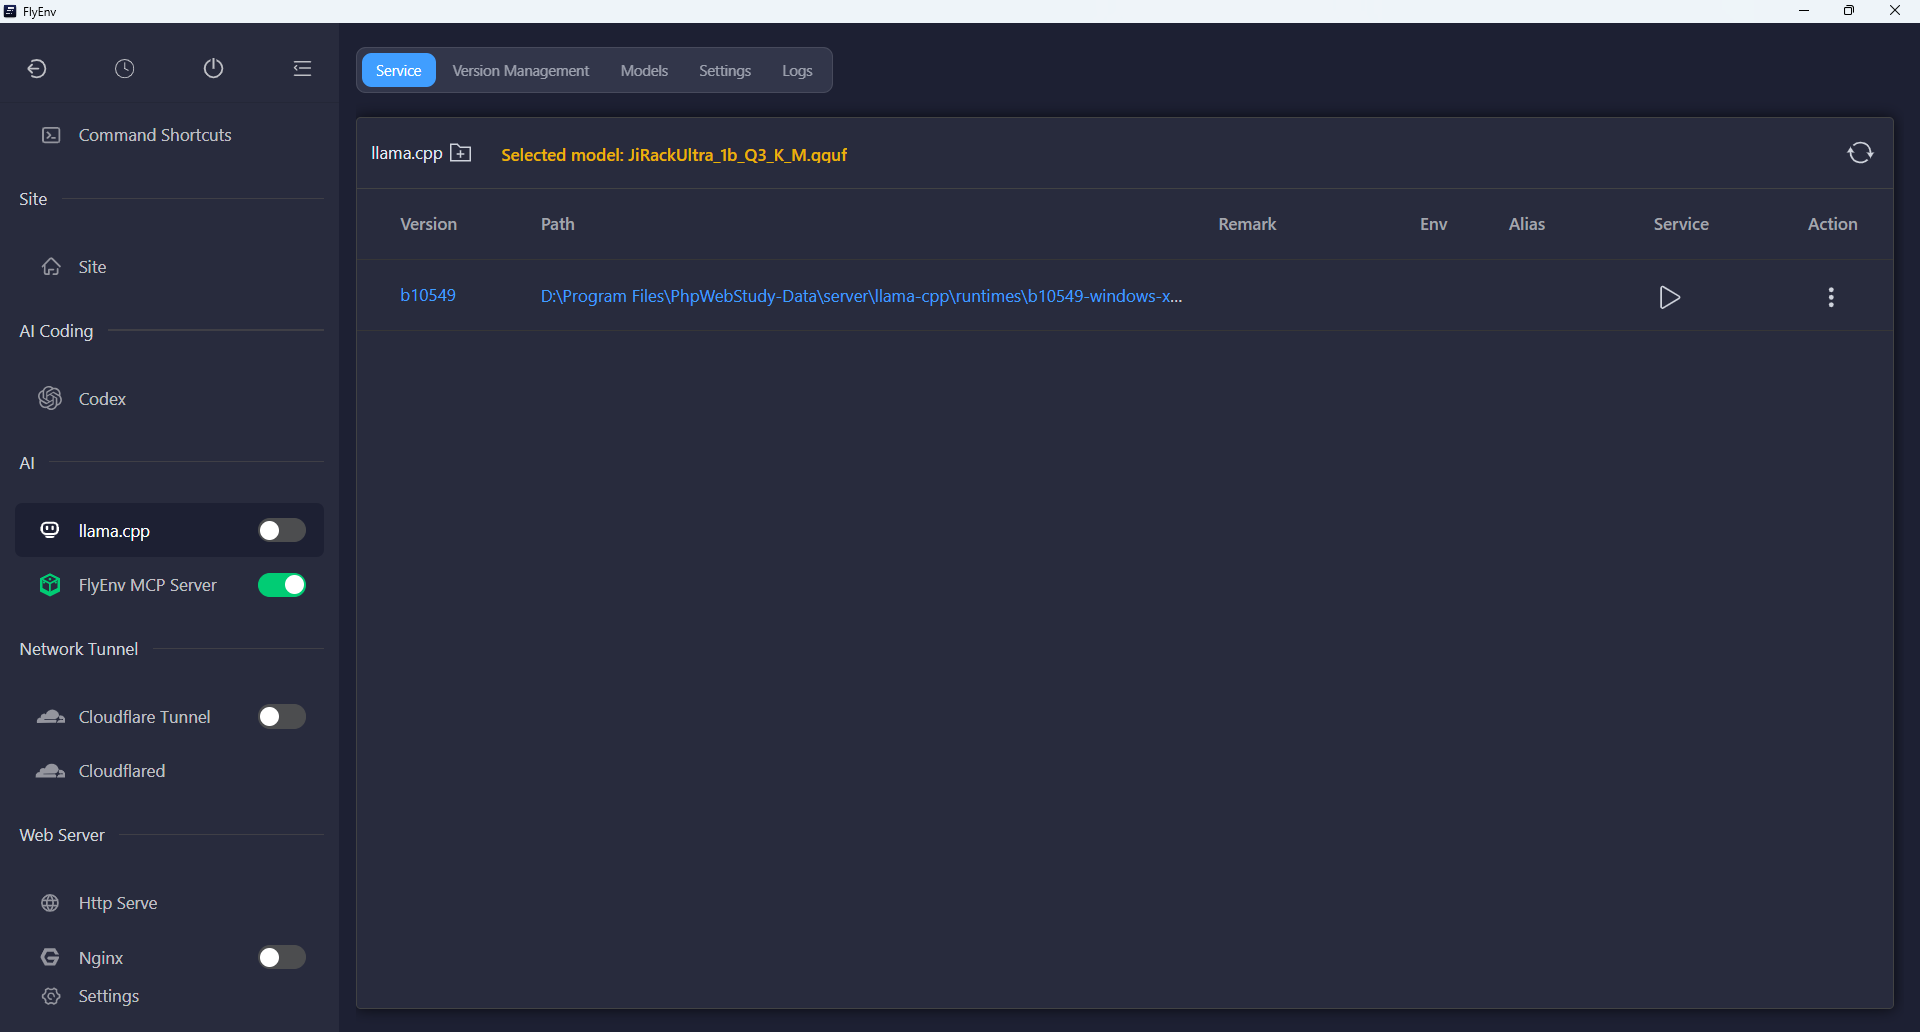
在 服务 页选择本地模型,再启动已安装的运行时。点击所选模型区域,可在弹出面板中切换模型,并查看、复制 兼容 OpenAI 的 Base URL,供客户端配置使用。
默认地址为 http://127.0.0.1:8080/v1。修改监听地址或端口后,显示的 URL 也会随之更新。服务运行中切换模型时,FlyEnv 会先请求确认,再用新模型重启服务。
支持连接 llama.cpp 兼容 OpenAI 接口的应用,就可以使用该模型。实际可用的 API 功能取决于所选运行时和模型。
推理设置
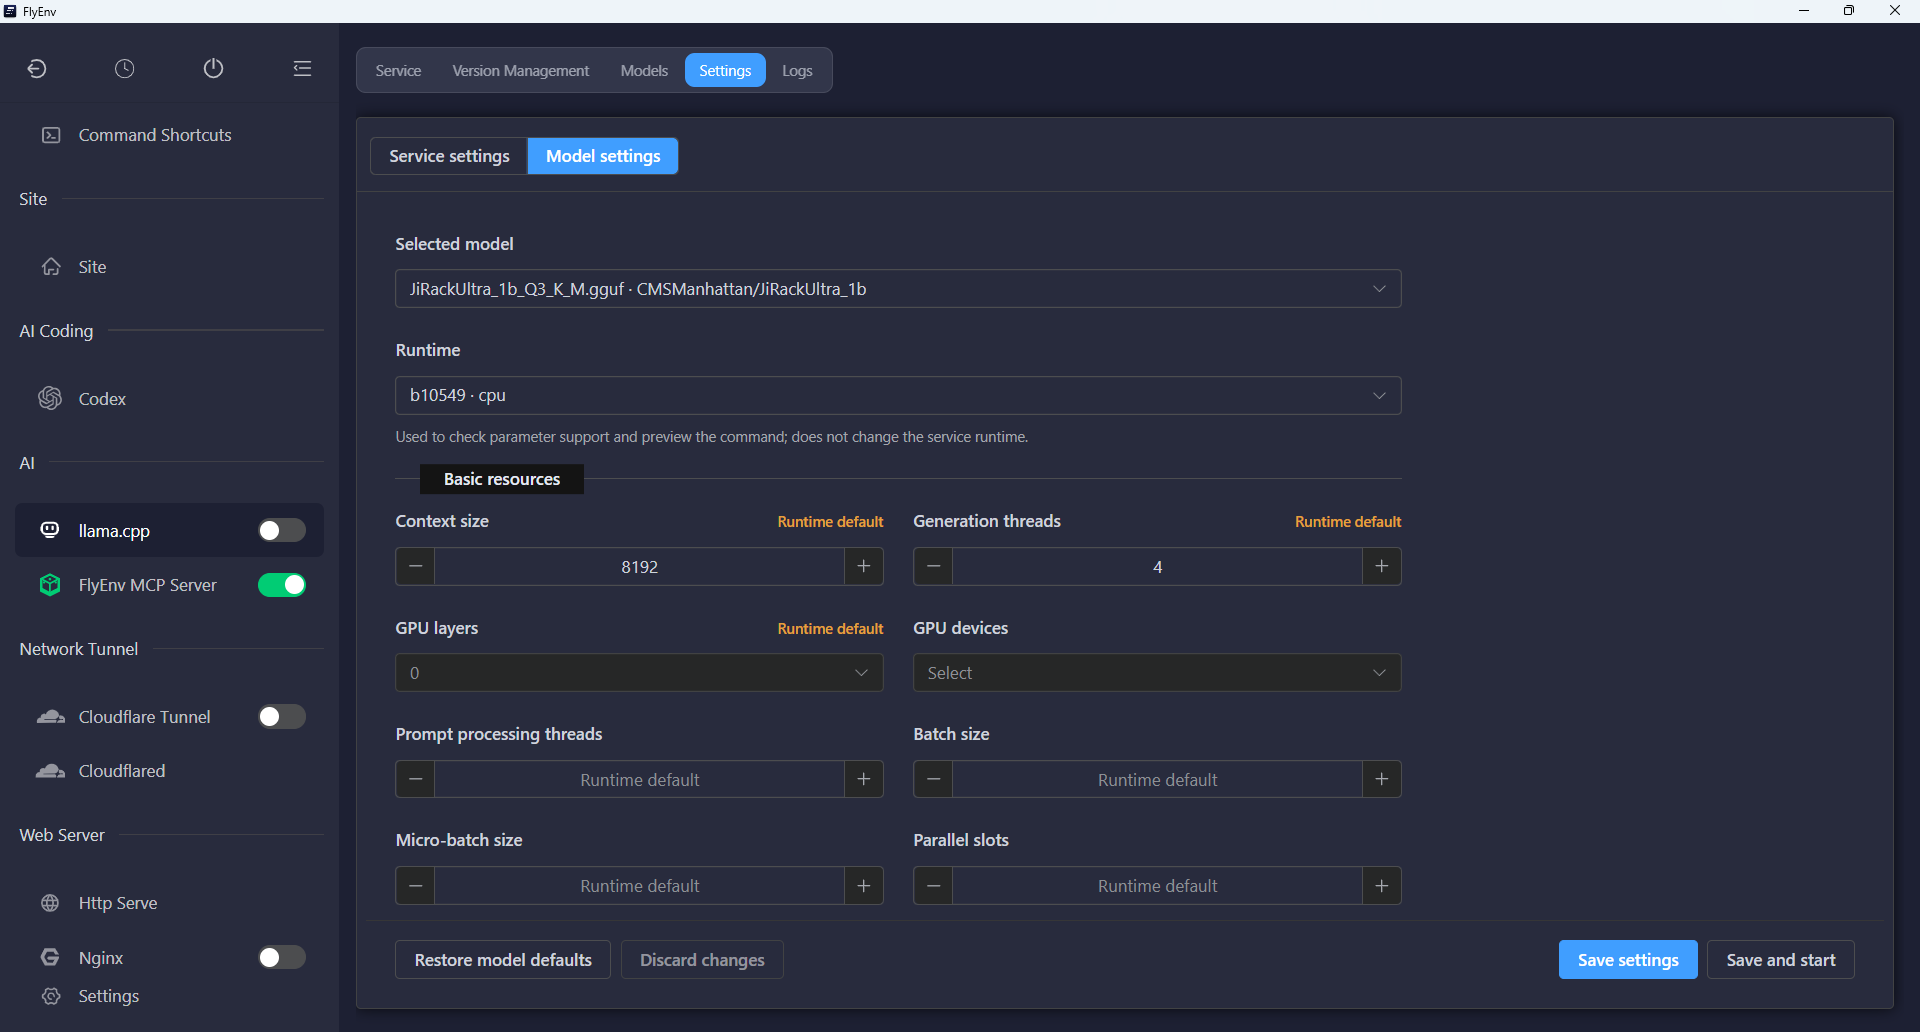
设置 分为 服务设置 和 模型设置:前者管理监听地址、端口及 API 密钥,后者管理所选模型的推理选项。
- 监听地址与端口: 设置 API 的监听位置。
- 上下文长度: 默认为 8192 个 token;更大的上下文会占用更多内存。
- CPU 线程: 设置推理线程数。
- GPU 层数与设备: 为兼容的后端配置 GPU 卸载。
- API 密钥: 生成或输入密钥,并在支持的平台上创建私有密钥文件。
绑定非回环地址需要配置 API 密钥。当前 Windows 实现只支持绑定回环地址。保存设置后,重启正在运行的服务,才能使用新的配置。
日志与兼容性
日志 页可查看所选运行时的服务输出和错误日志,用于排查模型加载、内存不足和后端初始化失败等问题。
下载运行时和模型需要网络及足够磁盘空间;安装好这些文件后,推理可以在本地完成。Linux 发行构建所需的系统库,可能比旧版发行版自带的更新。此模块安装已发布的二进制文件,不会从源码编译 llama.cpp。