llama.cpp en FlyEnv
llama.cpp ejecuta inferencia de grandes modelos de lenguaje en C y C++. Su complemento para FlyEnv reúne la instalación de runtimes, la descarga de modelos GGUF y un servidor de inferencia local en un único módulo, con ajustes de CPU y GPU.
Instala llama.cpp desde Settings → Plugin Market. Su entrada en la barra lateral abre las pestañas Service, Version Management, Models, Settings y Logs.
Demostración en vídeo
Mira cómo instalar el complemento, gestionar runtimes y modelos GGUF, ajustar el modelo e iniciar la inferencia local en FlyEnv.
Versiones del runtime y backends
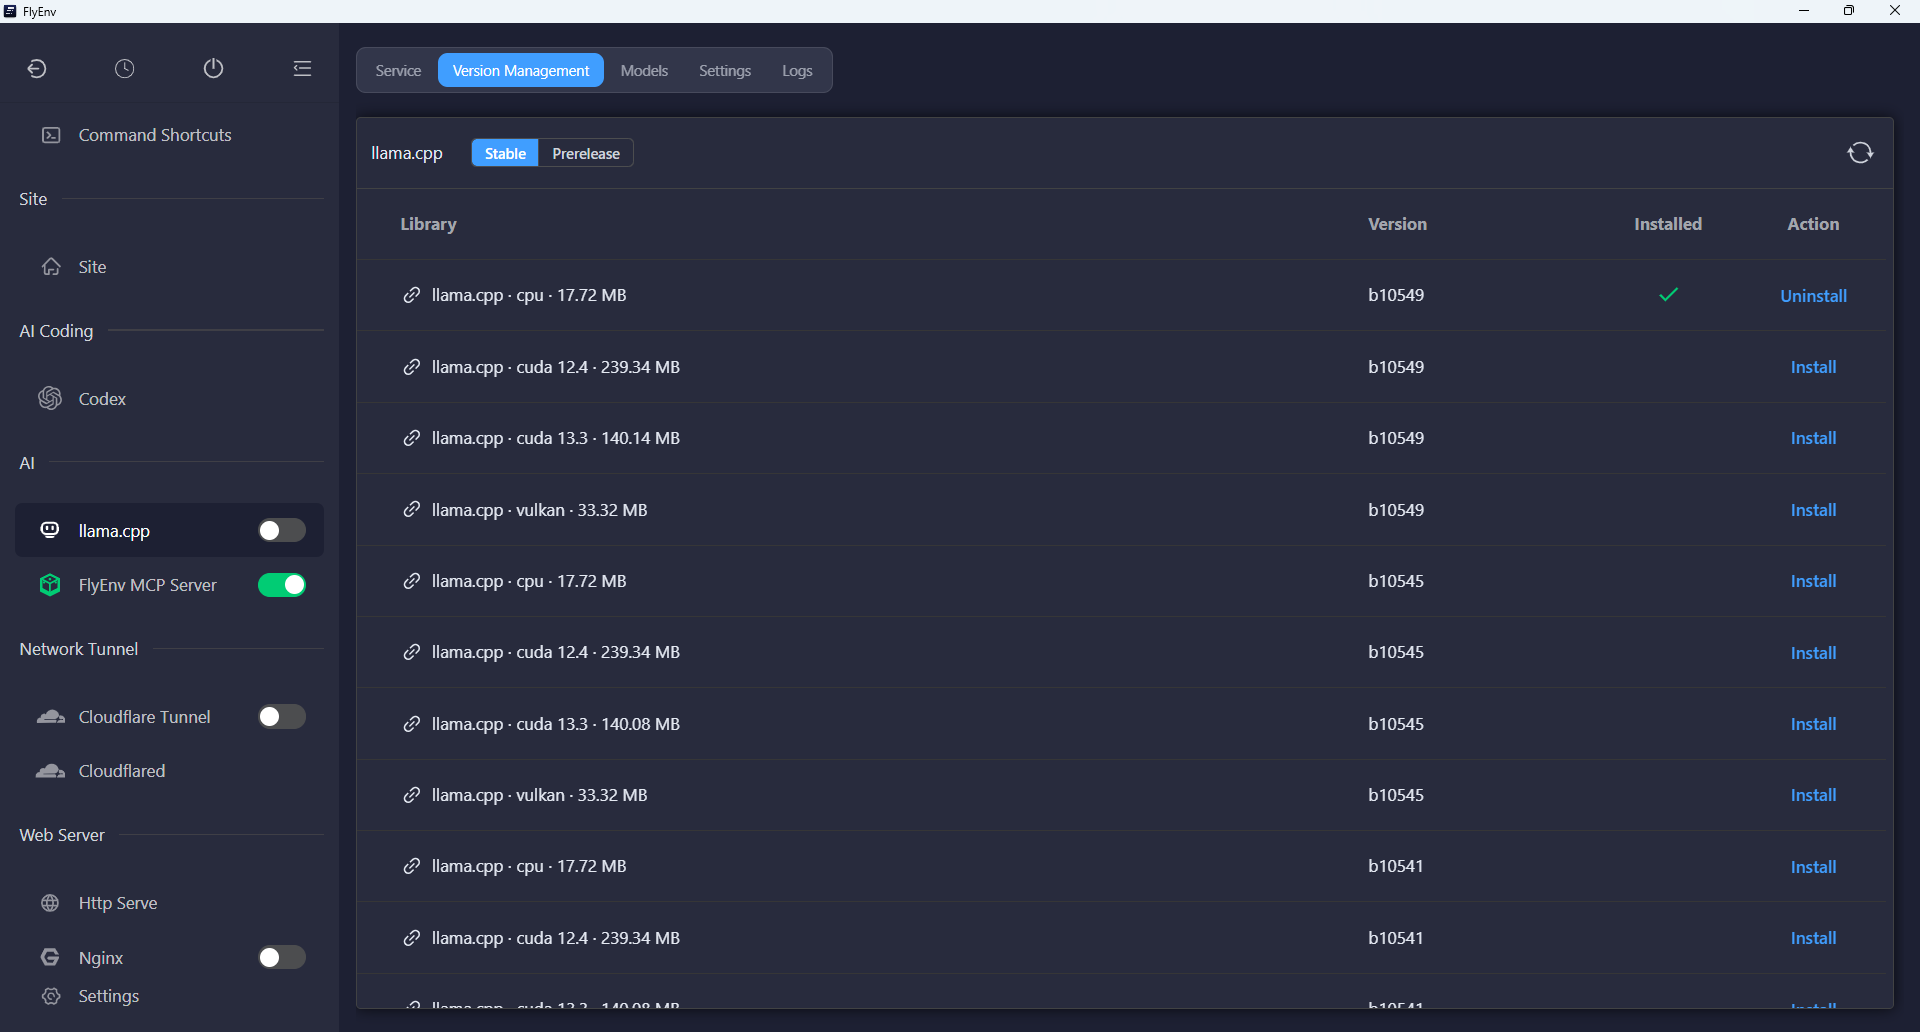
La pestaña Version Management muestra las compilaciones publicadas por el proyecto que son compatibles con tu sistema operativo y arquitectura. Actualiza la lista, elige una versión y un backend e instala el runtime que necesites. La lista distingue las versiones estables de las preliminares.
Puedes descargar varias versiones a la vez y conservarlas en paralelo. Elige en Service qué runtime instalado quieres iniciar; instalar otra versión no pone en marcha otro servidor.
El complemento admite estas combinaciones cuando el proyecto publica los archivos correspondientes:
- macOS con Apple Silicon: compilaciones Metal.
- Windows x64: compilaciones CPU, CUDA y Vulkan.
- Linux x64: compilaciones CPU, CUDA y Vulkan.
- Linux ARM64: compilaciones CPU y Vulkan.
Las variantes CUDA también instalan el archivo de dependencias correspondiente. FlyEnv comprueba el ejecutable del servidor instalado antes de aceptar el runtime. Los controladores de GPU y las bibliotecas del sistema deben cumplir los requisitos de la compilación elegida.
Biblioteca de modelos GGUF
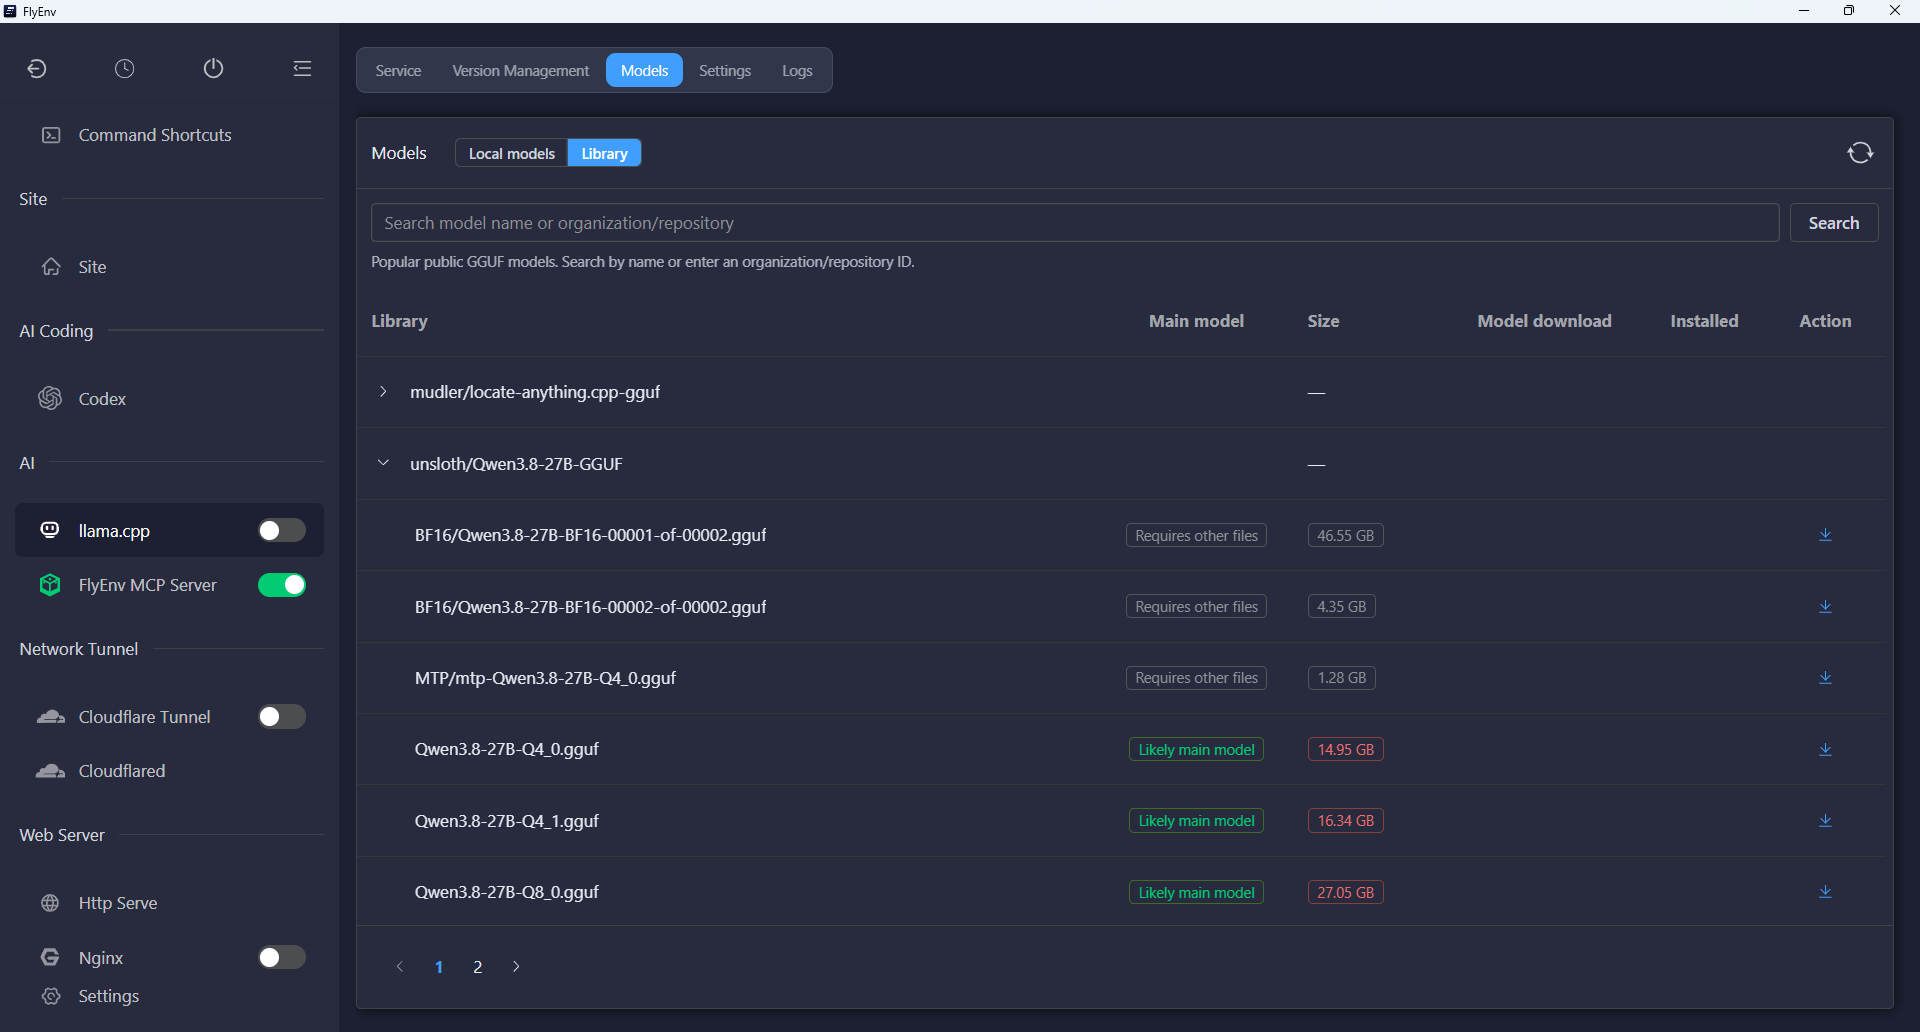
Abre Models → Library para explorar repositorios GGUF públicos de Hugging Face. Busca por nombre de modelo o introduce un identificador de organización/repositorio, despliega sus archivos y compara los tamaños antes de descargar. La vista incluye información del repositorio, la licencia del modelo cuando se indica y un resumen de la RAM/VRAM del equipo.
Las descargas muestran su progreso y se pueden cancelar. Local models enumera los archivos descargados y permite seleccionarlos o eliminarlos. La biblioteca distingue los posibles modelos principales de los archivos auxiliares; el selector del servicio solo admite modelos GGUF que puedan utilizarse de forma independiente. Los fragmentos de modelos y los archivos que necesitan recursos adicionales no se pueden seleccionar como modelos autónomos del servidor.
Elige un modelo que se ajuste a la memoria disponible. Su tamaño, la longitud del contexto y el número de capas que se ejecutan en la GPU influyen en los recursos necesarios para ejecutarlo.
Servir el modelo seleccionado
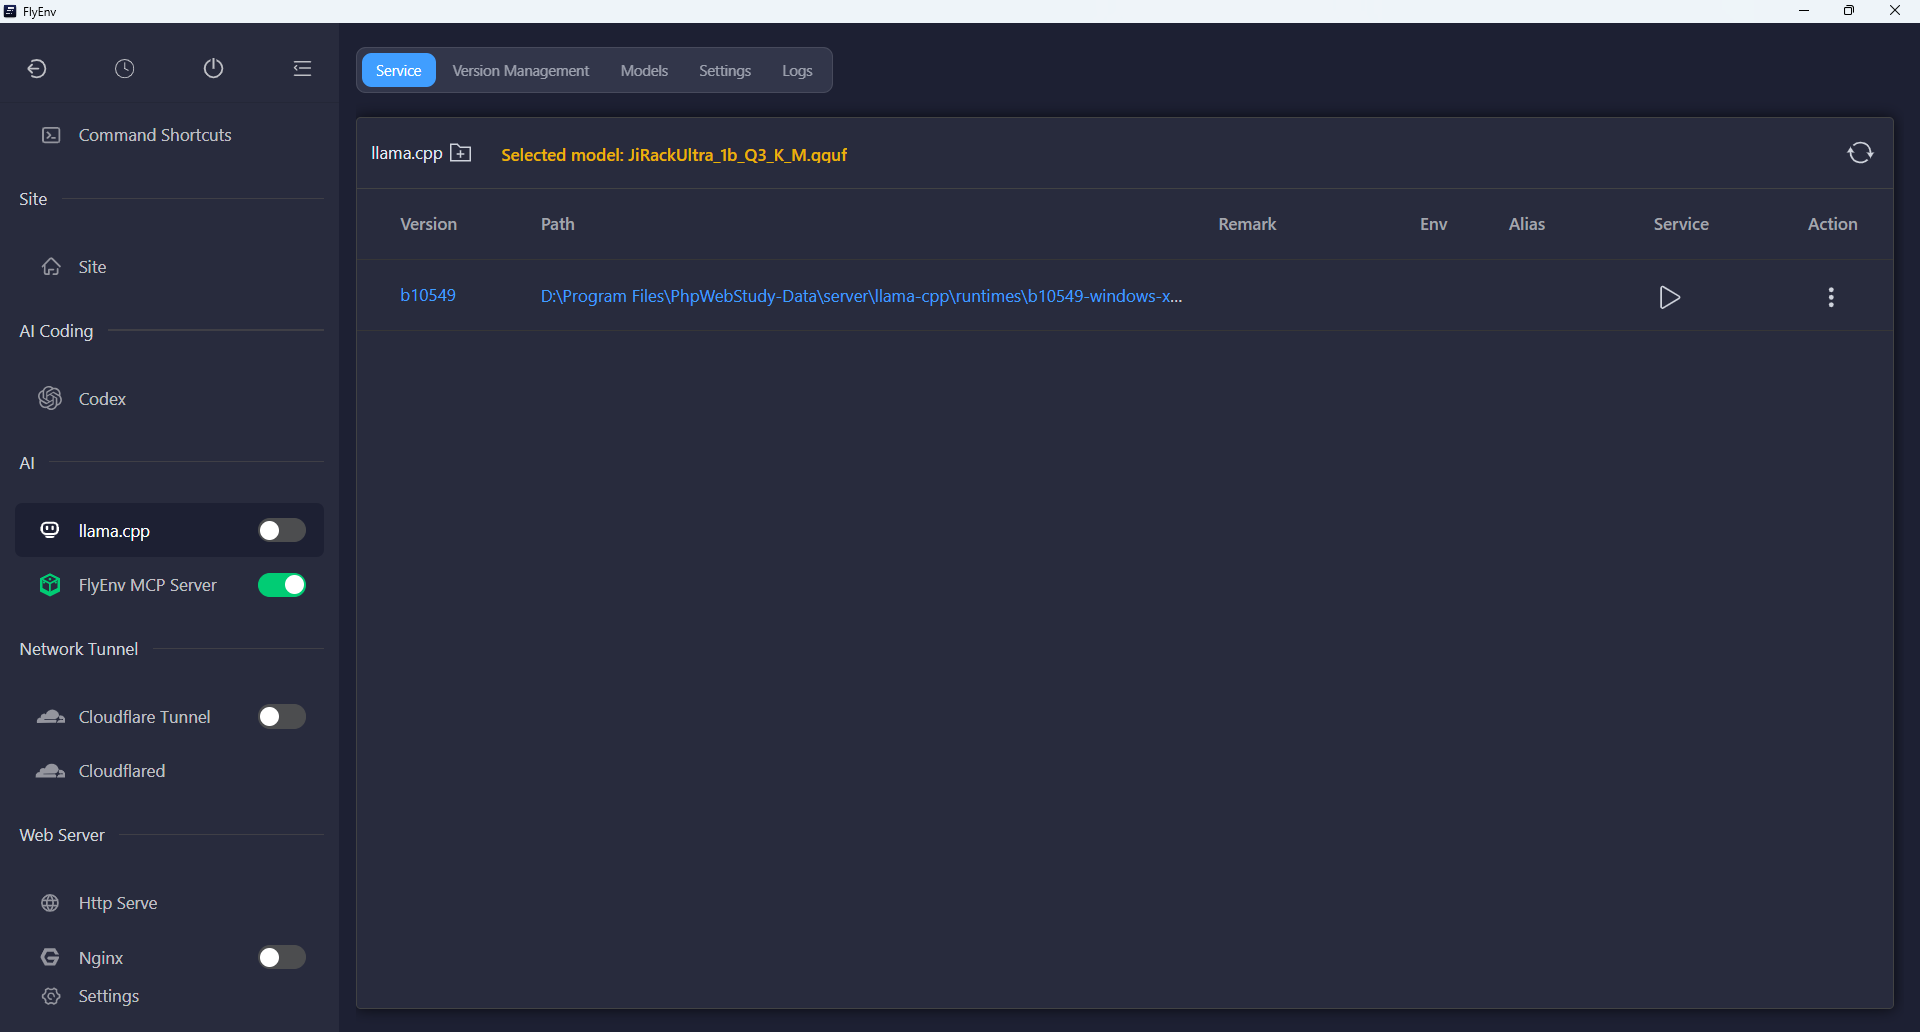
En Service, selecciona un modelo local e inicia un runtime instalado. El panel del modelo seleccionado incluye el selector y la OpenAI-compatible Base URL, con un botón para copiar la dirección a la configuración del cliente.
La URL predeterminada es http://127.0.0.1:8080/v1. Si cambias el host o el puerto, la dirección mostrada se actualiza. Cambiar de modelo mientras el servidor está en marcha requiere confirmación y reinicia el servicio con la nueva selección.
Así puedes utilizar el modelo desde aplicaciones capaces de conectarse al endpoint de llama.cpp compatible con OpenAI. Las funciones concretas de la API dependen del runtime y del modelo elegidos.
Ajustes de inferencia
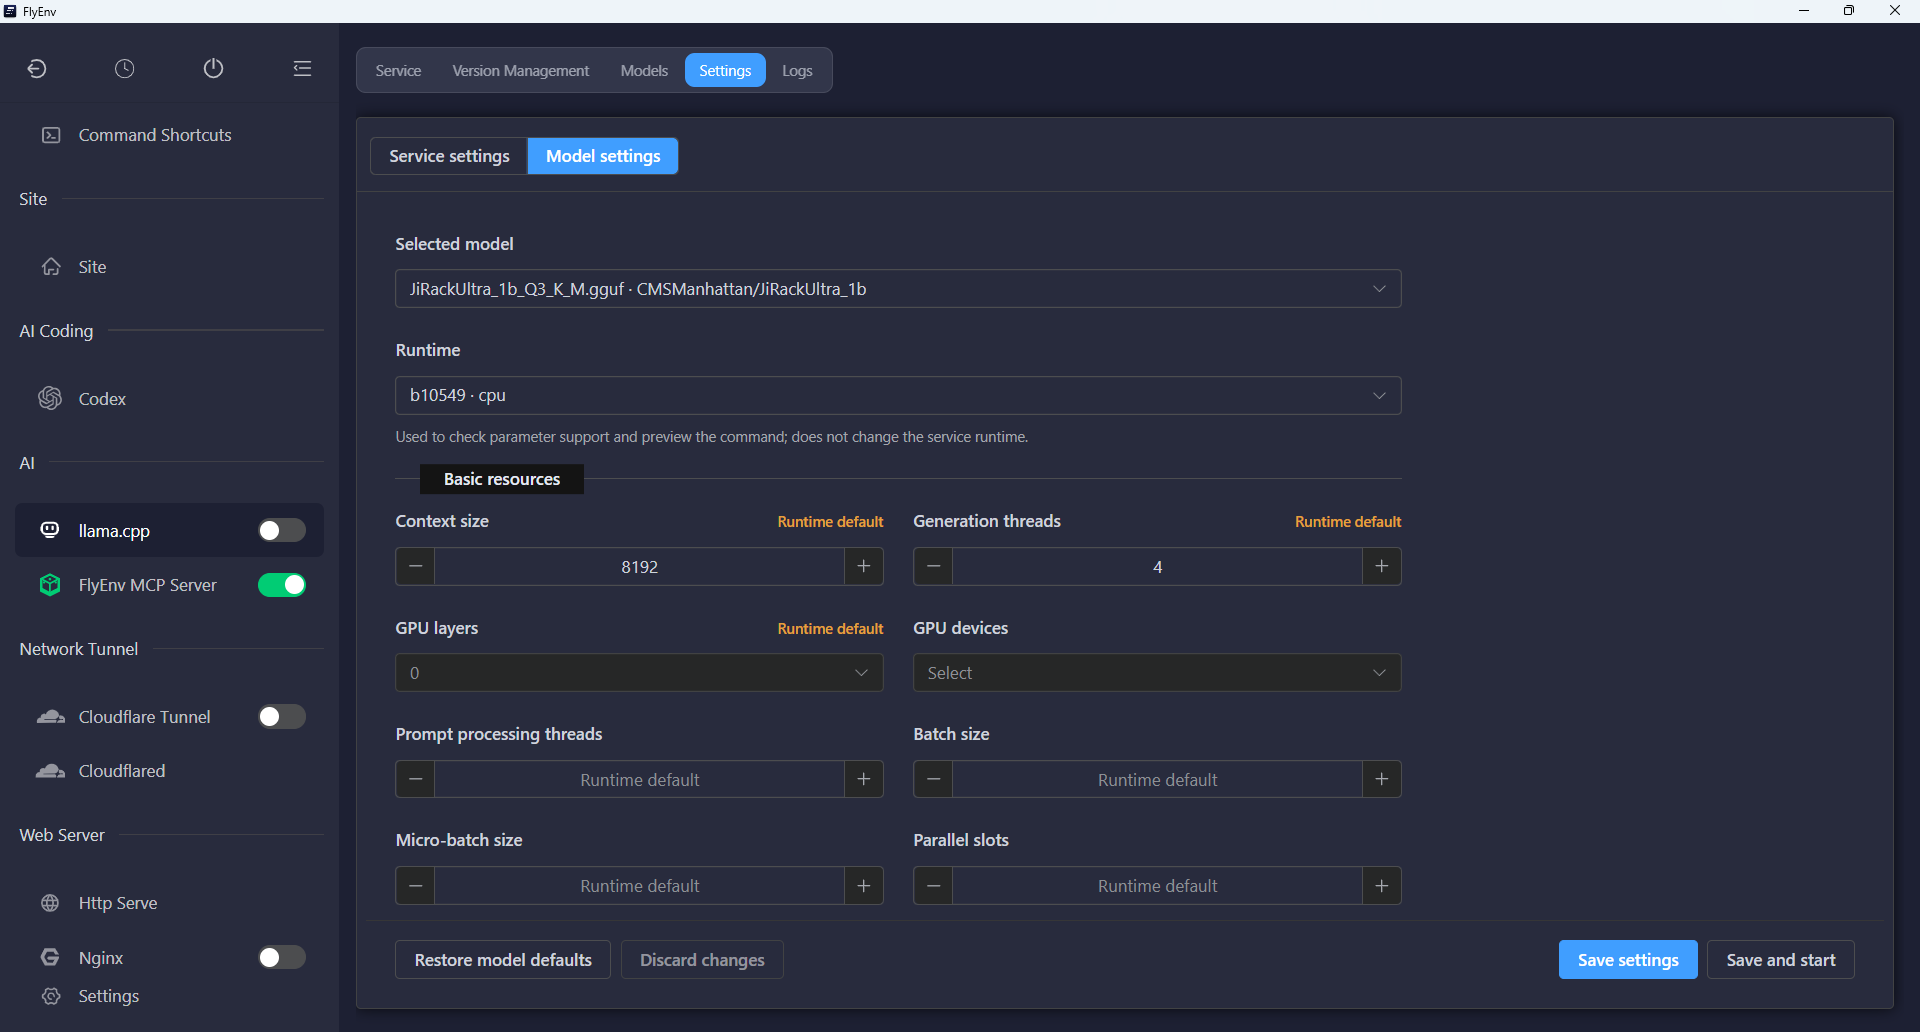
La pestaña Settings separa Service settings, para la dirección de escucha, el puerto y la clave de API, de Model settings, para las opciones de inferencia del modelo seleccionado:
- Host y puerto: elige dónde escucha la API.
- Longitud del contexto: el valor predeterminado es de 8192 tokens; los valores más altos consumen más memoria.
- Hilos de CPU: establece cuántos hilos utiliza la inferencia.
- Capas y dispositivo GPU: ajusta la ejecución en GPU con un backend compatible.
- Clave de API: genera o introduce una clave y crea un archivo privado de claves cuando la plataforma lo permita.
Escuchar en una dirección distinta de la de bucle local requiere una clave de API. La implementación actual de Windows solo admite direcciones de bucle local. Guarda los cambios y reinicia el servicio si está en marcha para aplicar el nuevo perfil.
Registros y compatibilidad
La pestaña Logs abre los registros de salida y errores del servidor correspondientes al runtime seleccionado. Son útiles para diagnosticar fallos al cargar el modelo, problemas de memoria y errores de inicialización del backend.
Las descargas de runtimes y modelos requieren acceso a la red y espacio en disco. Una vez instalados esos recursos, la inferencia puede ejecutarse localmente. Las compilaciones de Linux pueden necesitar bibliotecas del sistema más recientes que las de una distribución antigua. El módulo instala binarios publicados y no compila llama.cpp desde el código fuente.
Consulta Ollama, el otro gestor de modelos locales de FlyEnv, o vuelve al catálogo de complementos para administrar esta integración.