llama.cpp trong FlyEnv
llama.cpp chạy suy luận mô hình ngôn ngữ lớn bằng C và C++. Plugin FlyEnv của nó đưa việc cài runtime, tải model GGUF và một server suy luận local về cùng một module, kèm các điều khiển cho thiết lập CPU và GPU.
Cài llama.cpp từ Settings → Plugin Market. Mục thanh bên của nó mở các tab Service, Version Management, Models, Settings và Logs.
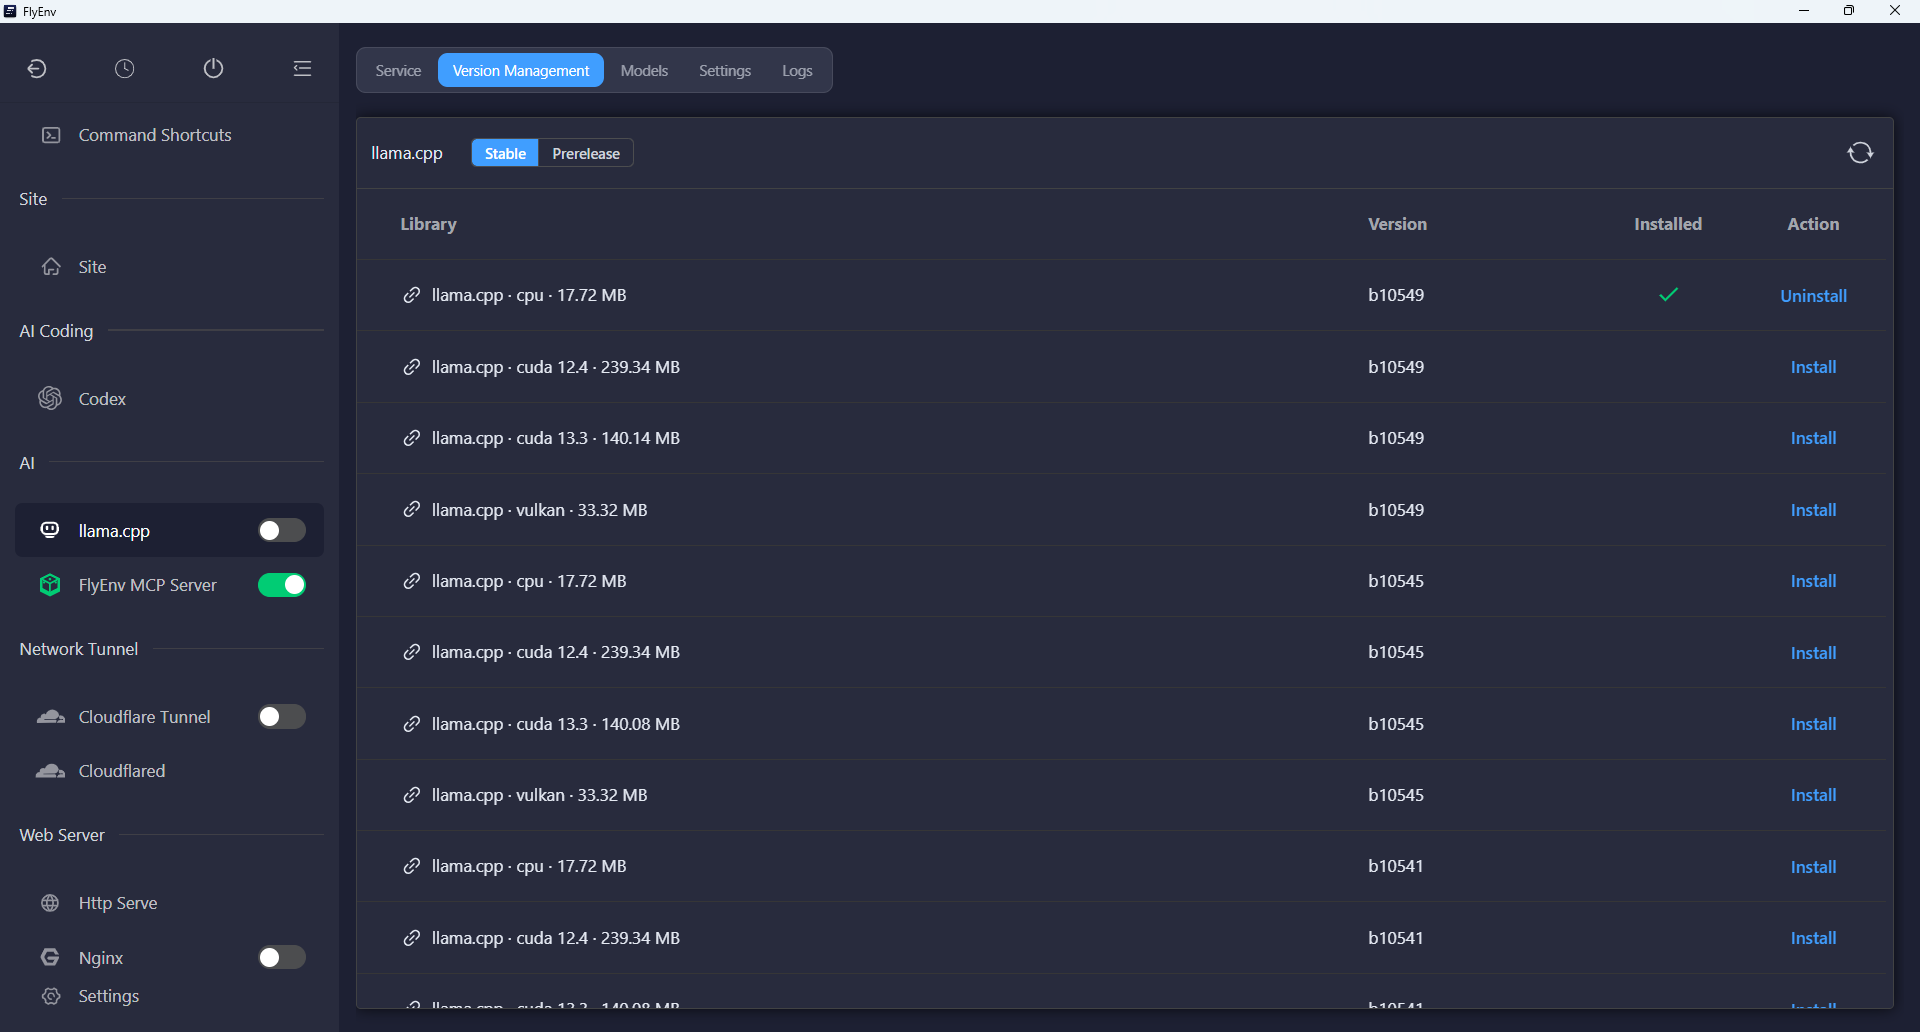
Phiên bản runtime và backend
Tab Version Management liệt kê các bản build phát hành upstream tương thích với hệ điều hành và kiến trúc của bạn. Làm mới danh sách, chọn một bản phát hành và backend, rồi cài runtime bạn cần. Các bản stable và prerelease được đánh dấu riêng trong danh sách.
Các phiên bản runtime khác nhau có thể được tải đồng thời và cùng tồn tại song song sau khi cài. Chọn runtime đã cài nào để khởi động trong tab Service; cài thêm một phiên bản không khởi động thêm một server khác.
Plugin hiện tại hỗ trợ các tổ hợp runtime sau đây khi các asset upstream có sẵn:
- macOS Apple Silicon: các bản build Metal.
- Windows x64: các bản build CPU, CUDA và Vulkan.
- Linux x64: các bản build CPU, CUDA và Vulkan.
- Linux ARM64: các bản build CPU và Vulkan.
Các biến thể CUDA còn cài thêm archive đồng hành khớp với nó. FlyEnv kiểm tra tệp thực thi server đã cài trước khi chấp nhận runtime; driver GPU và thư viện hệ thống vẫn phải đáp ứng yêu cầu của bản build.
Thư viện model GGUF
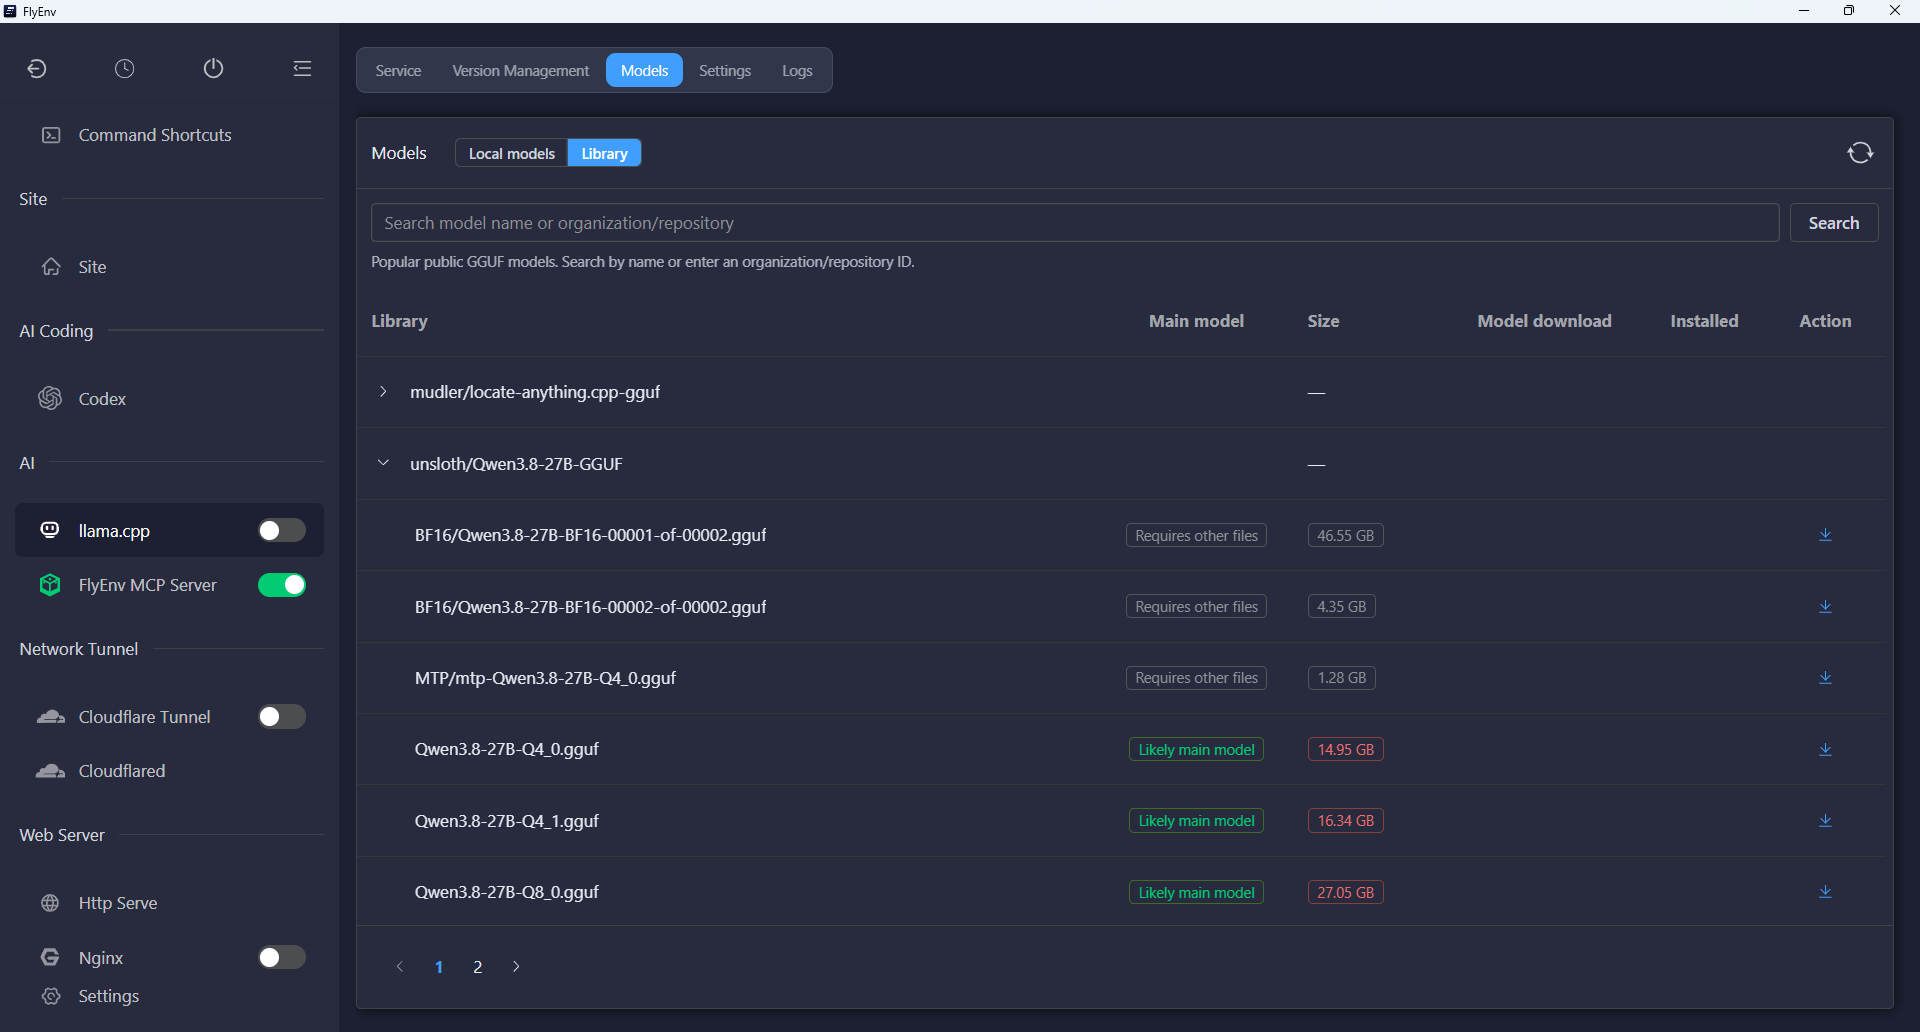
Mở Models → Library để duyệt các kho GGUF công khai trên Hugging Face. Tìm theo tên model hay nhập một ID organization/repository, mở rộng các tệp của một kho và so sánh kích thước của chúng trước khi tải. Khung nhìn gồm thông tin kho, giấy phép model khi được cung cấp, và một tóm tắt RAM/VRAM cho máy của bạn.
Các bản tải hiển thị tiến độ và có thể hủy. Local models liệt kê các tệp đã tải và cung cấp các điều khiển chọn và xóa. Thư viện phân biệt các model chính tiềm năng với các tệp hỗ trợ; bộ chọn dịch vụ chỉ chấp nhận các model GGUF độc lập. Các shard tách rời và các tệp cần asset bổ sung không thể chọn làm model server độc lập.
Hãy chọn một model vừa với bộ nhớ khả dụng của bạn. Kích thước model, độ dài context và thiết lập GPU offload đều ảnh hưởng tới tài nguyên cần để chạy nó.
Phục vụ một model đã chọn
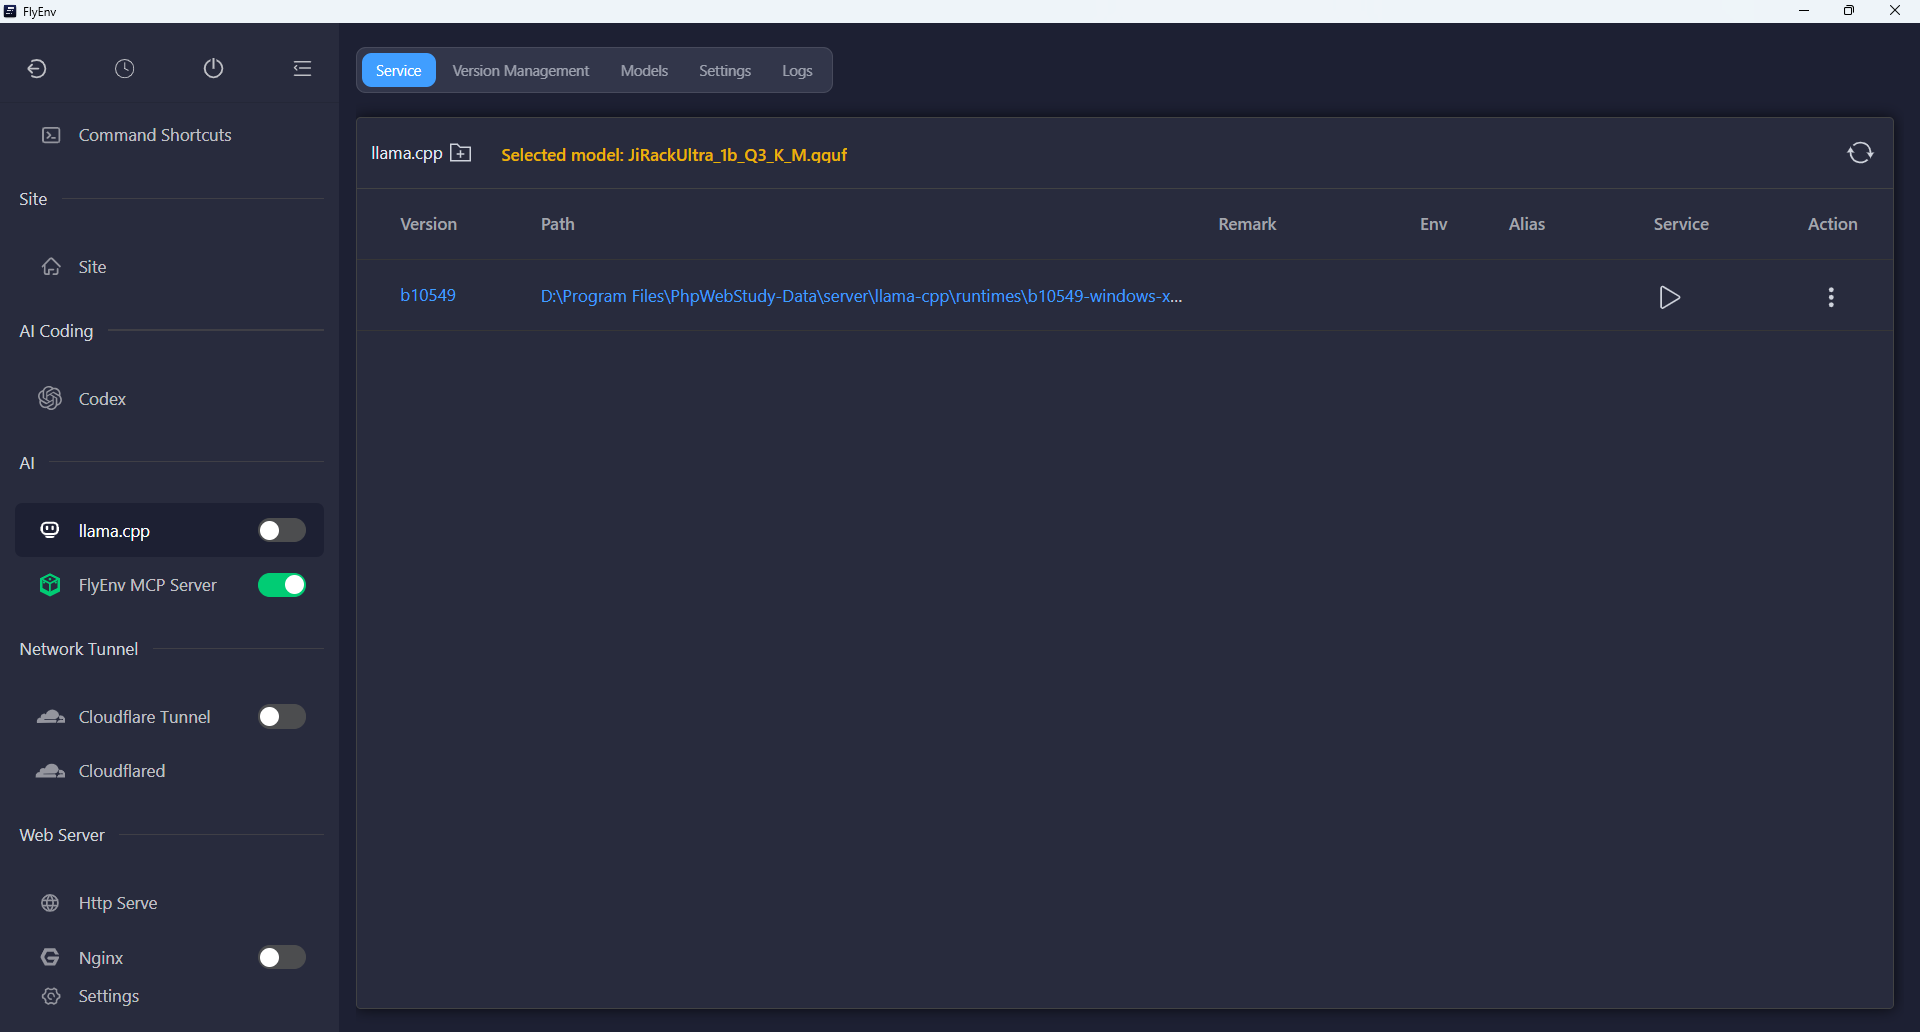
Trong Service, chọn một model local và khởi động một runtime đã cài. Popover model đã chọn hiển thị bộ chọn model cùng OpenAI-compatible Base URL, kèm một nút sao chép điểm cuối vào cấu hình client của bạn.
Base URL mặc định là http://127.0.0.1:8080/v1. Nếu bạn đổi host hay cổng, URL hiển thị sẽ theo các thiết lập đó. Đổi model khi server đang chạy sẽ hỏi xác nhận và khởi động lại dịch vụ với lựa chọn mới.
Nhờ đó model trở nên khả dụng cho các ứng dụng có thể kết nối tới một endpoint tương thích OpenAI của llama.cpp. Khả năng API thực tế phụ thuộc vào runtime và model bạn chọn.
Thiết lập suy luận
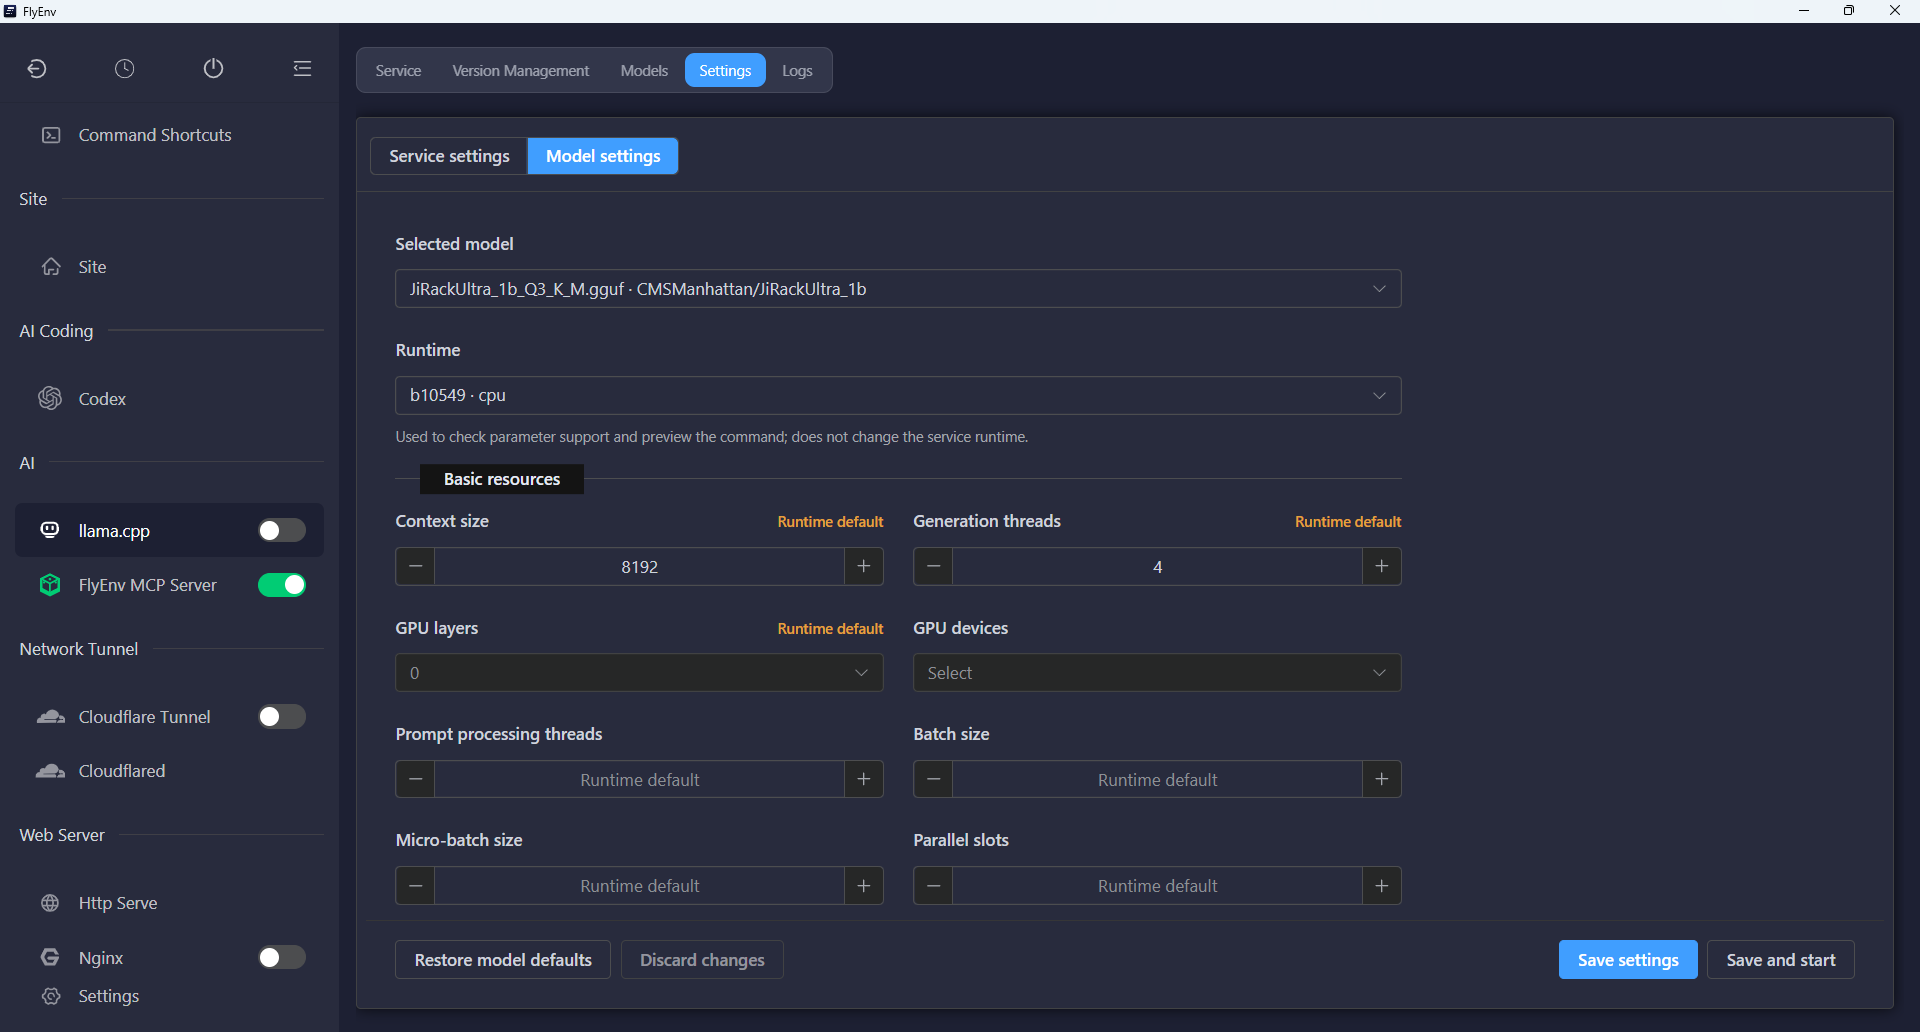
Tab Settings tách Service settings cho địa chỉ bind, cổng và API key khỏi Model settings cho các tùy chọn suy luận của model đã chọn:
- Bind host và cổng: chọn nơi API lắng nghe.
- Context size: mặc định là 8192 token; giá trị lớn hơn dùng nhiều bộ nhớ hơn.
- CPU threads: đặt số luồng cho suy luận.
- GPU layers và device: chọn thiết lập GPU offload cho một backend tương thích.
- API key: sinh hay nhập một key và tạo tệp key riêng tư nơi được hỗ trợ.
Bind ngoài loopback đòi hỏi một API key. Cài đặt Windows hiện tại chỉ hỗ trợ bind loopback. Hãy lưu các thiết lập và khởi động lại dịch vụ đang chạy để dùng hồ sơ đã cập nhật.
Log và tương thích
Tab Logs mở log đầu ra và log lỗi của server cho runtime được chọn. Chúng giúp chẩn đoán lỗi nạp model, bộ nhớ và khởi tạo backend.
Tải runtime và model cần truy cập mạng cùng dung lượng đĩa; suy luận có thể chạy local sau khi các asset đó đã được cài. Các bản build phát hành cho Linux có thể đòi thư viện hệ thống mới hơn những gì một bản phân phối cũ cung cấp. Module cài các binary đã phát hành và không biên dịch llama.cpp từ mã nguồn.
Xem Ollama cho trình quản lý model local khác của FlyEnv, hay quay lại Plugin Market để quản lý tích hợp này.