llama.cpp di FlyEnv
llama.cpp menjalankan inferensi model bahasa besar dengan C dan C++. Plugin FlyEnv menyatukan instalasi runtime, unduhan model GGUF, dan server inferensi lokal dalam satu modul, dengan pengaturan CPU serta GPU.
Instal llama.cpp melalui Settings → Plugin Market. Modul di bilah samping menyediakan tab Service, Version Management, Models, Settings, dan Logs.
Video demo
Lihat cara memasang plugin, mengelola runtime dan model GGUF, menyesuaikan pengaturan model, serta menjalankan inferensi lokal di FlyEnv.
Tonton di YouTube atau Bilibili.
Versi runtime dan backend
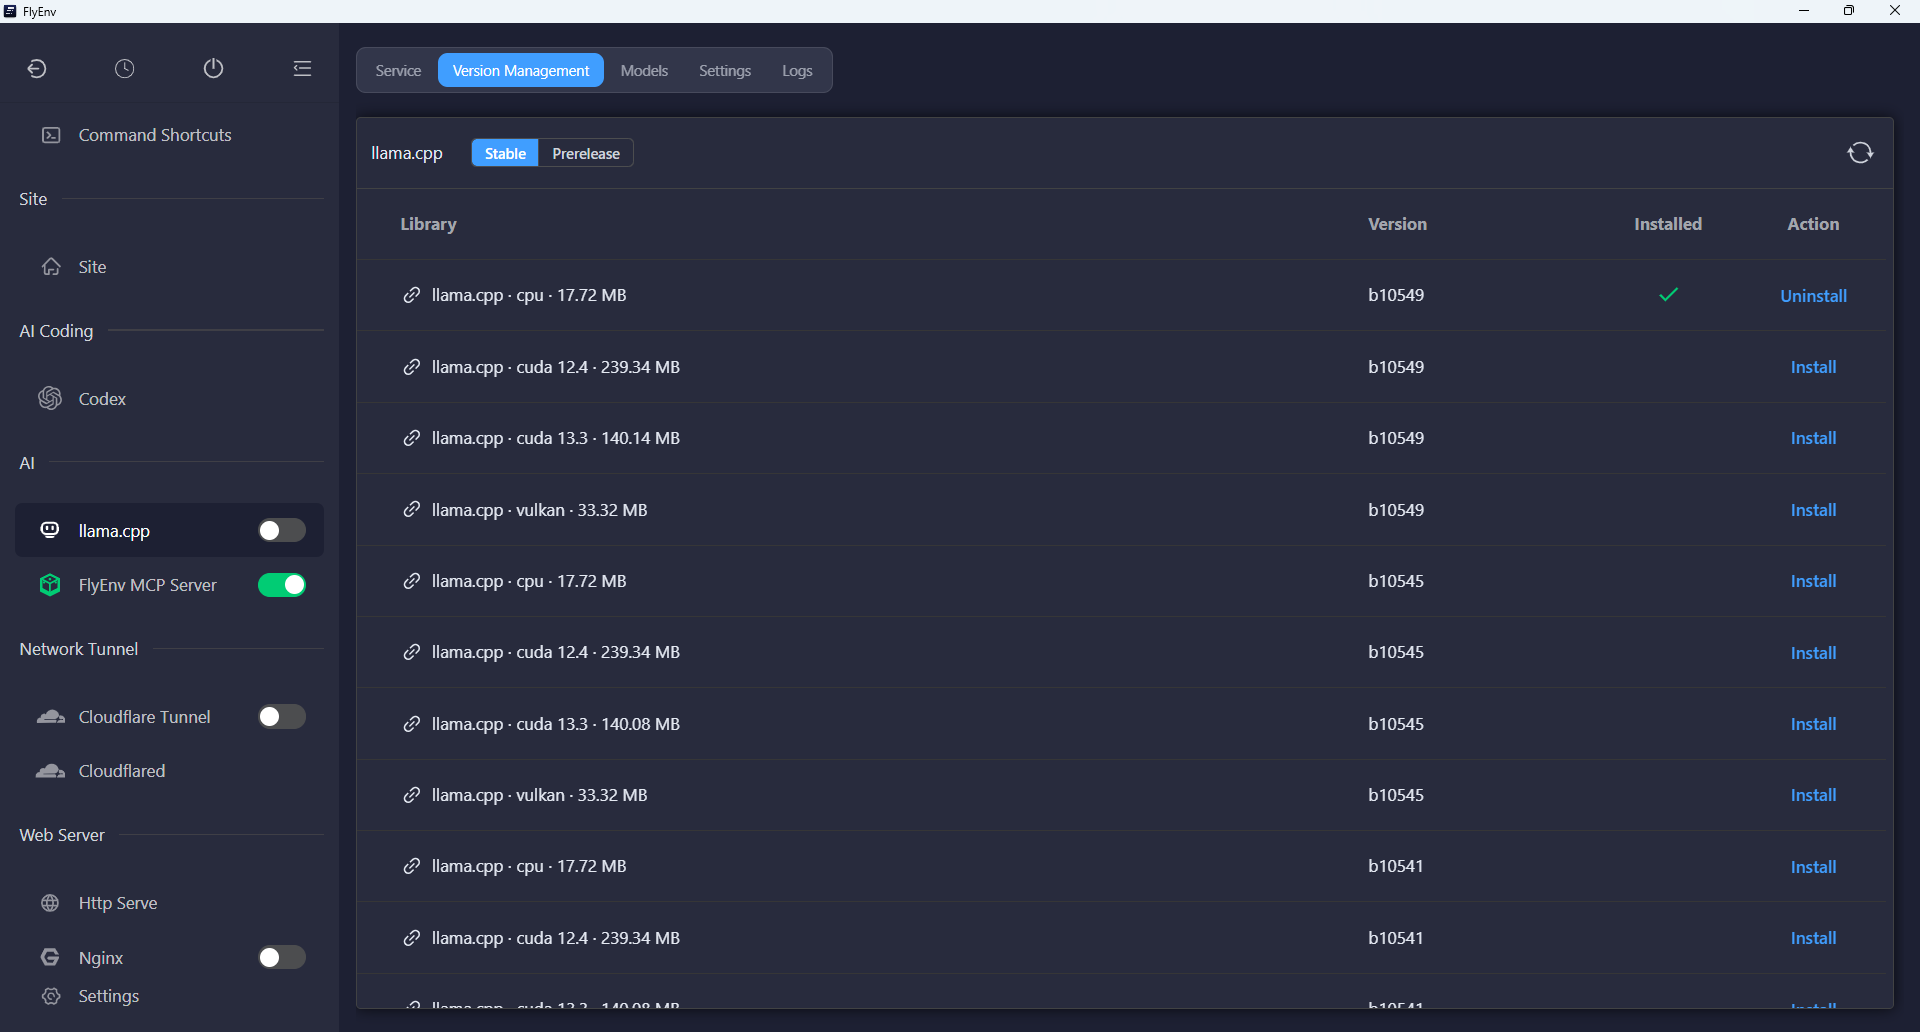
Tab Version Management menampilkan build rilis upstream yang sesuai dengan sistem operasi dan arsitektur Anda. Segarkan daftar, pilih rilis serta backend, lalu instal runtime yang dibutuhkan. Rilis stabil dan prarilis diberi penanda dalam daftar.
Beberapa versi runtime dapat diunduh bersamaan dan disimpan berdampingan. Pilih runtime terpasang yang akan dijalankan pada tab Service; memasang versi tambahan tidak otomatis menjalankan server lain.
Plugin mendukung kombinasi berikut jika berkas rilisnya tersedia di upstream:
- macOS Apple Silicon: build Metal.
- Windows x64: build CPU, CUDA, dan Vulkan.
- Linux x64: build CPU, CUDA, dan Vulkan.
- Linux ARM64: build CPU dan Vulkan.
Varian CUDA juga memasang arsip pendamping yang sesuai. FlyEnv memeriksa executable server setelah instalasi sebelum menerima runtime tersebut. Driver GPU dan pustaka sistem tetap harus memenuhi persyaratan build yang dipilih.
Pustaka model GGUF
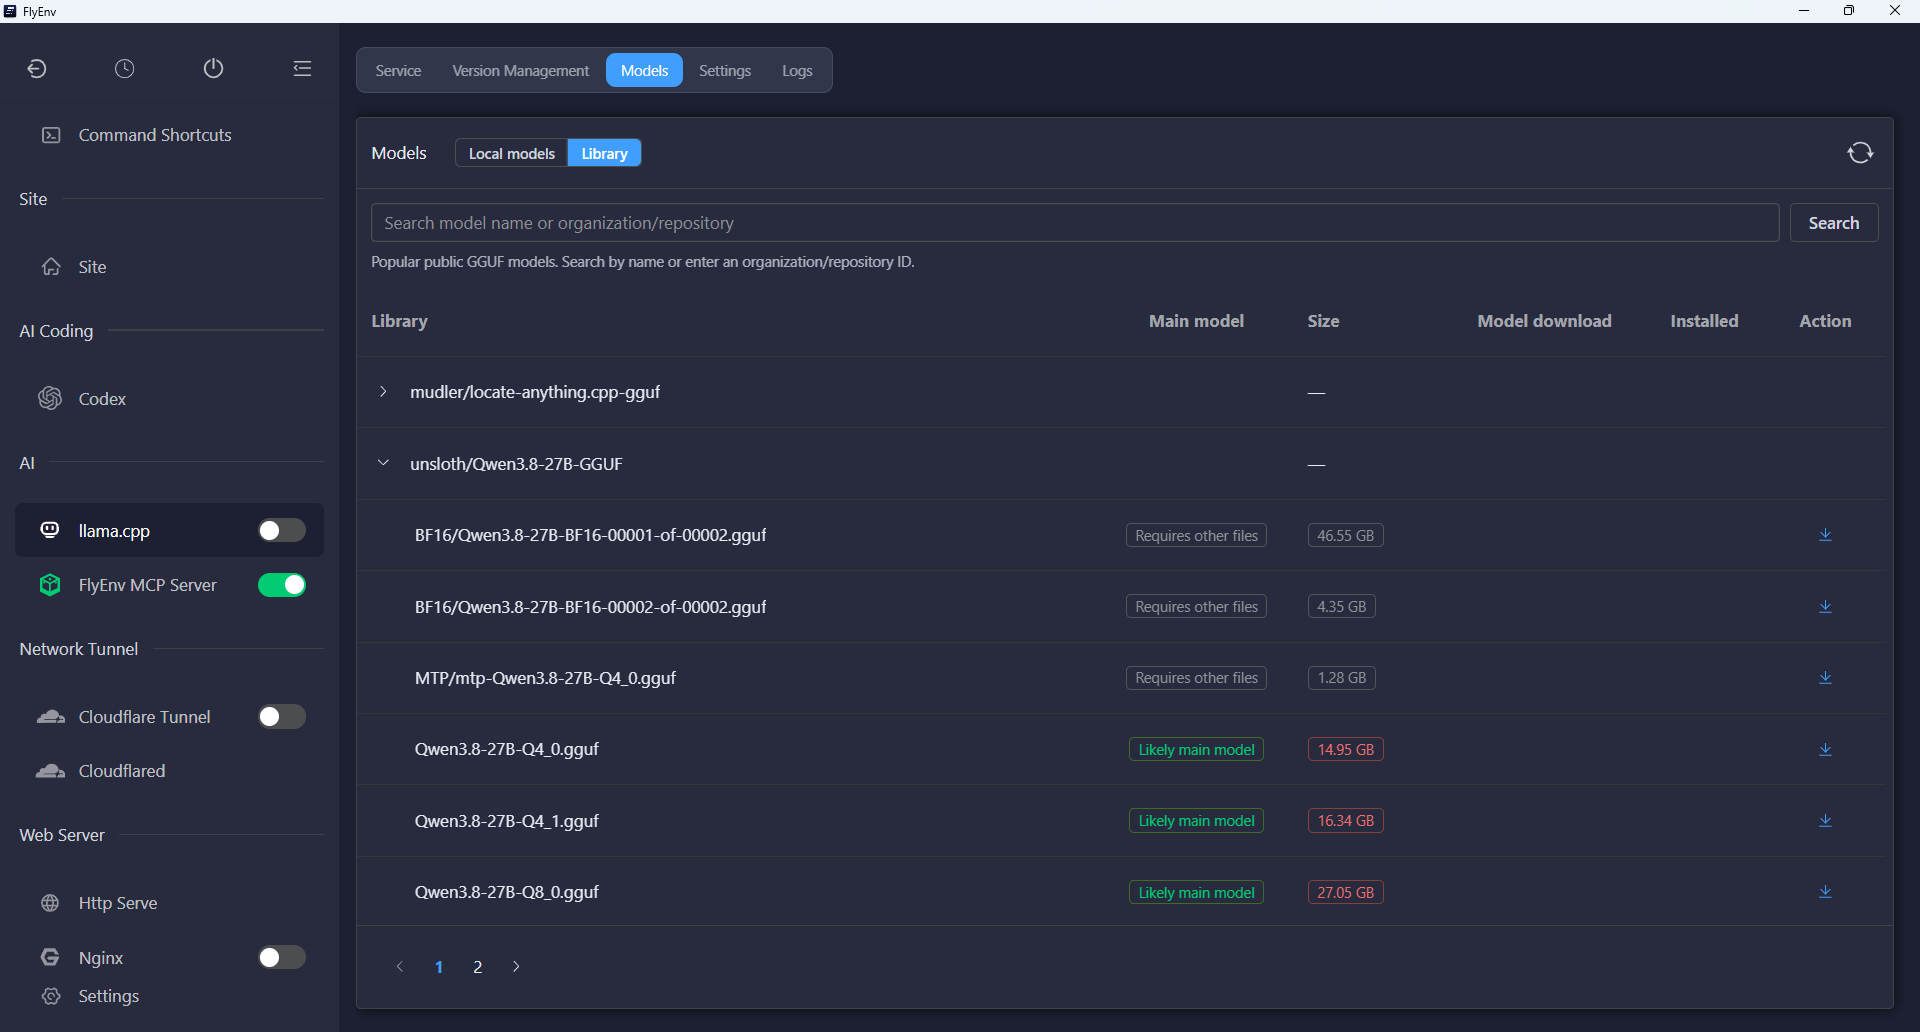
Buka Models → Library untuk menelusuri repositori GGUF publik di Hugging Face. Cari nama model atau masukkan ID organisasi/repositori, buka daftar berkas, lalu bandingkan ukurannya sebelum mengunduh. Tampilan ini juga menyediakan informasi repositori, lisensi model jika dicantumkan, dan ringkasan RAM/VRAM komputer Anda.
Unduhan menampilkan progres dan dapat dibatalkan. Local models mencantumkan berkas yang telah diunduh, dengan kontrol untuk memilih dan menghapusnya. Pustaka membedakan berkas yang kemungkinan merupakan model utama dari berkas pendukung; pemilih model layanan hanya menerima GGUF yang dapat digunakan secara mandiri. Pecahan model dan berkas yang memerlukan aset tambahan tidak dapat dipilih sebagai model server mandiri.
Pilih model yang sesuai dengan memori yang tersedia. Ukuran model, panjang konteks, dan pengaturan pemindahan komputasi ke GPU memengaruhi kebutuhan sumber daya saat model dijalankan.
Menjalankan layanan untuk model pilihan
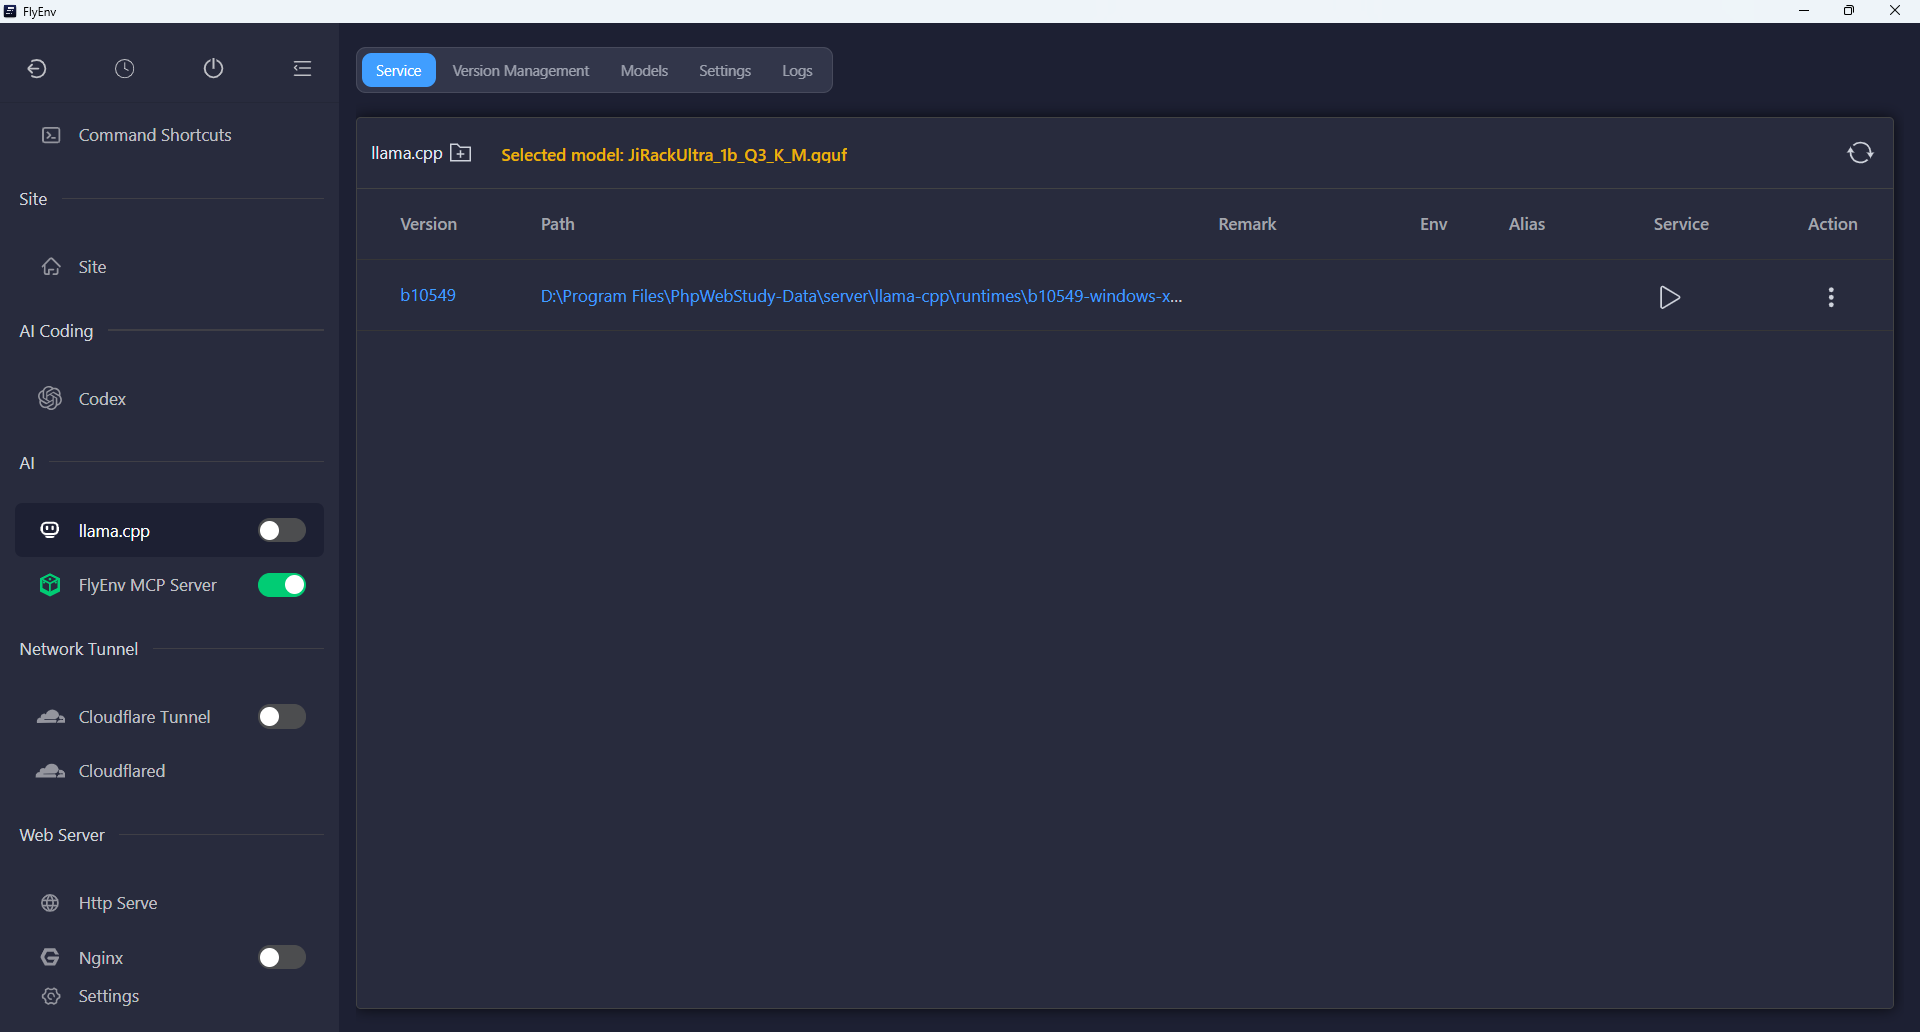
Pada tab Service, pilih model lokal dan jalankan runtime yang sudah terpasang. Panel model terpilih menyediakan pemilih model dan OpenAI-compatible Base URL, beserta tombol untuk menyalin endpoint ke konfigurasi klien.
Alamat bawaannya adalah http://127.0.0.1:8080/v1. Jika host atau port diubah, URL yang ditampilkan ikut diperbarui. Mengganti model ketika server berjalan memerlukan konfirmasi dan akan memulai ulang layanan dengan model baru.
Model kemudian dapat digunakan oleh aplikasi yang mendukung endpoint llama.cpp yang kompatibel dengan OpenAI. Kemampuan API yang tersedia bergantung pada runtime dan model yang dipilih.
Pengaturan inferensi
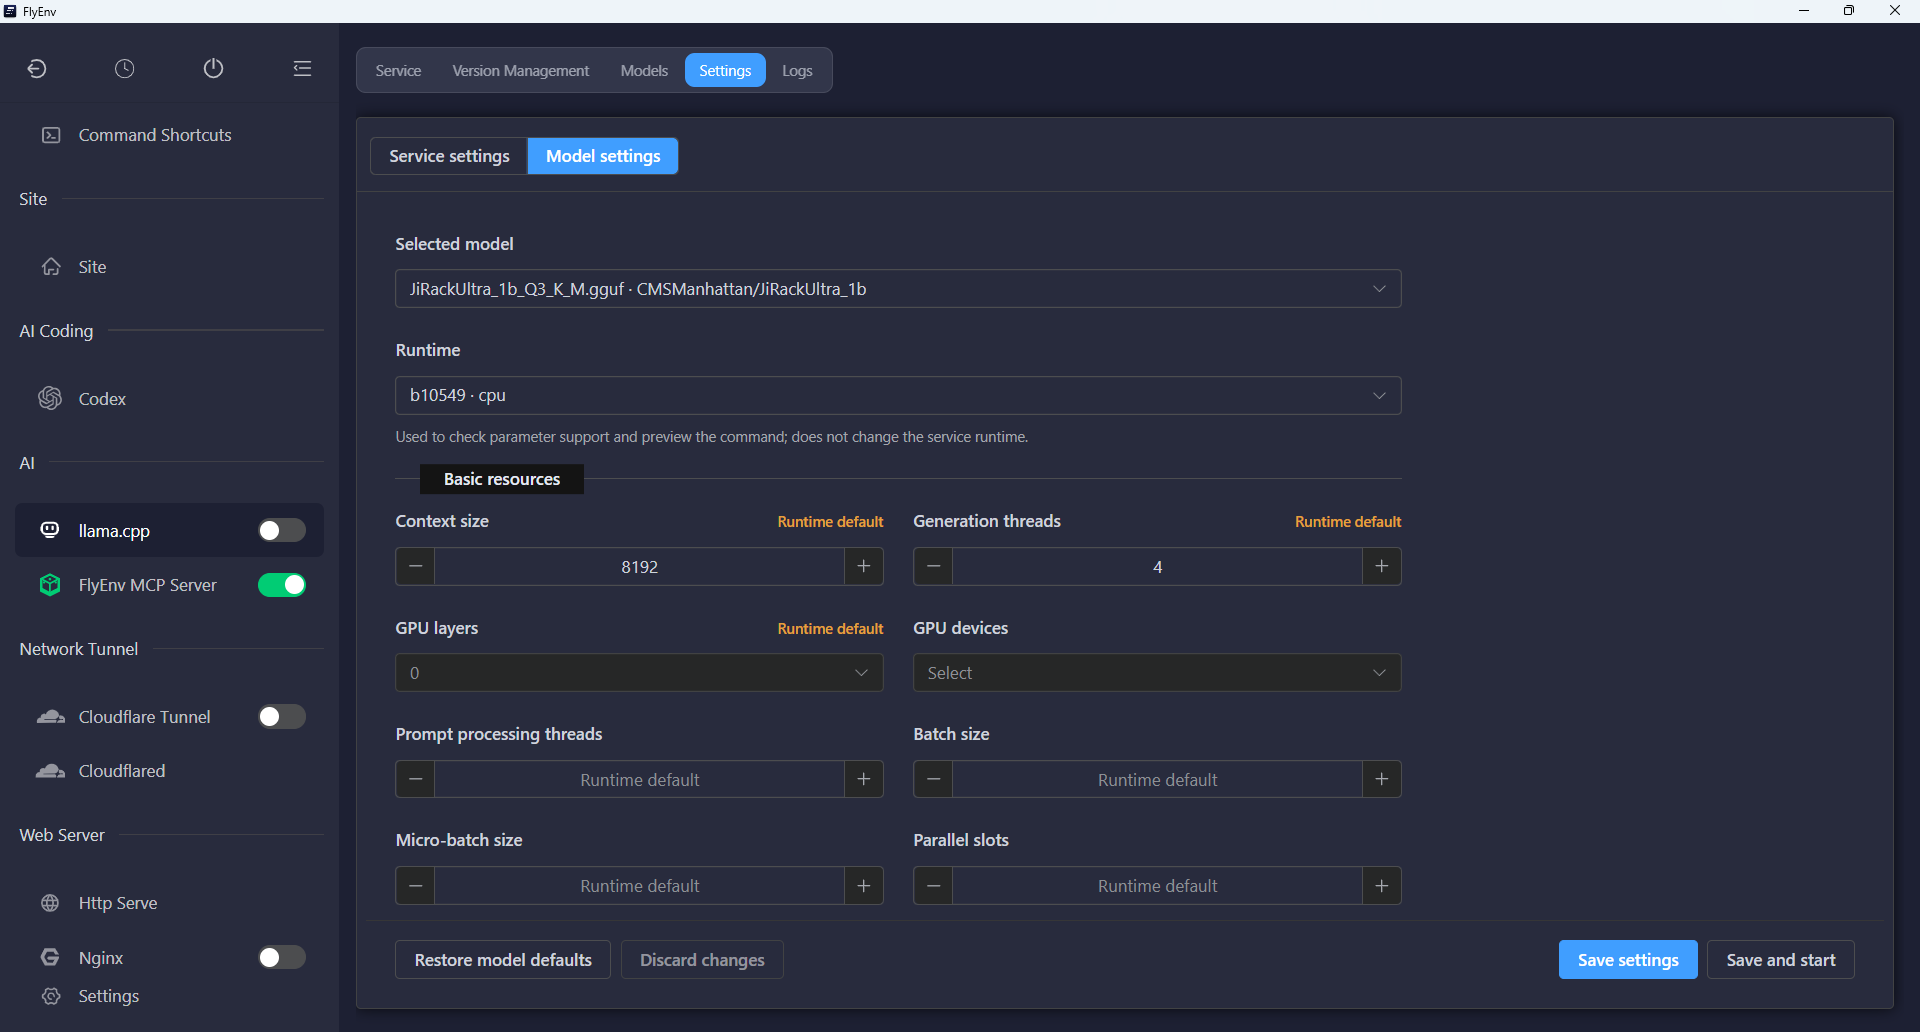
Tab Settings memisahkan Service settings untuk alamat, port, dan kunci API dari Model settings untuk opsi inferensi model terpilih:
- Host dan port: tentukan alamat tempat API menerima koneksi.
- Panjang konteks: secara bawaan 8192 token; nilai lebih besar menggunakan lebih banyak memori.
- Thread CPU: atur jumlah thread untuk inferensi.
- Lapisan dan perangkat GPU: sesuaikan penggunaan GPU pada backend yang mendukungnya.
- Kunci API: buat atau masukkan kunci, lalu buat berkas kunci privat pada platform yang mendukungnya.
Mendengarkan pada alamat selain loopback memerlukan kunci API. Implementasi Windows saat ini hanya mendukung alamat loopback. Simpan pengaturan dan mulai ulang layanan yang sedang berjalan untuk menggunakan konfigurasi baru.
Log dan kompatibilitas
Tab Logs membuka log keluaran dan kesalahan server untuk runtime terpilih. Gunakan log ini untuk menelusuri kegagalan pemuatan model, masalah memori, atau kegagalan inisialisasi backend.
Mengunduh runtime dan model memerlukan koneksi jaringan serta ruang disk. Setelah aset terpasang, inferensi dapat dijalankan secara lokal. Build Linux mungkin memerlukan pustaka sistem yang lebih baru daripada yang tersedia pada distribusi lama. Modul ini memasang biner yang telah dirilis dan tidak mengompilasi llama.cpp dari kode sumber.
Lihat juga Ollama, pengelola model lokal lainnya di FlyEnv, atau kembali ke Pasar Plugin untuk mengelola integrasi ini.